---
# Só mude aqui!!!!
author: "Bruno Henrique e Lucas Felipe"
title: "Relatório de Aula Prática 03"
bibliography: referencias.bib
# A partir daqui nao faca alteracoes!!!!!
link-citations: true
csl: associacao-brasileira-de-normas-tecnicas-ipea.csl
subtitle: "<a href='https://bendeivide.github.io/courses/epaec/' target='_blank'>Estatística e Probabilidade</a> </br> <a href='https://bendeivide.github.io' target='_blank'>Prof. Ben Dêivide (DEFIM/CAP/UFSJ)</a>"
include-before-body: header.html
date: now
date-format: "DD/MM/YYYY, HH:mm"
lang: pt-BR
format:
html:
toc: true
number-sections: true
theme: bootstrap
css: styles.css
code-fold: true
code-tools: true
execute:
echo: true
warning: false
message: false
---
## 📌 Introdução
No contexto da Engenharia Civil, o controle tecnológico do concreto desempenha um papel fundamental na verificação da qualidade e do desempenho dos materiais empregados nas obras. Durante a execução de um empreendimento, são produzidos diversos dados provenientes de ensaios laboratoriais, registros de campo e informações relacionadas às características do concreto. Esses dados podem fornecer informações importantes para o acompanhamento da qualidade, a identificação de possíveis problemas e o apoio à tomada de decisões técnicas.
Entretanto, antes da realização de qualquer análise estatística, é necessário verificar a qualidade e a consistência das informações disponíveis. Em situações reais, bases de dados podem apresentar valores ausentes, erros de digitação, diferentes formas de registro de uma mesma categoria, problemas relacionados à utilização de vírgulas e pontos decimais, valores com ordem de grandeza inadequada e outras inconsistências. Dessa forma, o tratamento e a organização dos dados constituem etapas essenciais para garantir que as análises realizadas posteriormente sejam confiáveis e representem adequadamente o fenômeno estudado.
Neste relatório, será analisada uma base de dados relacionada ao controle tecnológico do concreto, composta por 100 observações e 10 variáveis que representam características como idade dos corpos de prova, resistência à compressão, consumo de cimento, relação água/cimento, abatimento, densidade e absorção de água dos agregados. A partir dessa base, serão realizadas etapas de inspeção, diagnóstico, organização, limpeza, transformação e exploração dos dados, buscando identificar possíveis inconsistências e avaliar a coerência das informações registradas.
Para o processamento da base, será utilizada a linguagem de programação R, com prioridade para os recursos da família tidyverse, especialmente os pacotes dplyr, tidyr, stringr, readr, purrr e ggplot2. A utilização dessas ferramentas permitirá estruturar um fluxo de tratamento dos dados de maneira organizada e reprodutível, desde a leitura da base original até a produção de informações e visualizações úteis para a análise.
Assim, o objetivo deste relatório é desenvolver uma abordagem prática de tratamento e exploração de dados aplicados à Engenharia Civil, demonstrando que a qualidade da análise depende não apenas dos métodos estatísticos empregados, mas também da identificação e do tratamento adequado dos problemas presentes nos dados. Ao final, pretende-se obter uma base organizada e consistente, capaz de fornecer informações relevantes para o acompanhamento do controle tecnológico do concreto e para a tomada de decisões no contexto da obra.
## 🎯 Objetivos
### Objetivo geral
Realizar a inspeção, organização, limpeza, transformação e exploração de uma base de dados relacionada ao controle tecnológico do concreto, utilizando a linguagem R e, prioritariamente, as ferramentas da família tidyverse, de modo a identificar inconsistências, corrigir problemas nos registros e obter informações relevantes para a avaliação da qualidade do concreto.
### Objetivos específicos
- Inspecionar a estrutura da base de dados e identificar os tipos e características das variáveis disponíveis;
Verificar a existência de valores ausentes, registros inconsistentes e possíveis erros de preenchimento ou digitação;
- Identificar problemas relacionados a formatos numéricos, casas decimais, unidades e ordem de grandeza dos valores;
- Padronizar variáveis categóricas e textuais, eliminando diferenças de formatação, espaços adicionais e formas distintas de representação;
- Organizar e transformar os dados utilizando, prioritariamente, funções dos pacotes dplyr, tidyr, stringr, readr e purrr;
- Criar uma versão tratada da base de dados, denominada dados_limpos, preservando a base original para fins de comparação e rastreabilidade;
- Explorar as características dos dados por meio de medidas estatísticas e representações gráficas;
- Utilizar o ggplot2 para produzir visualizações que auxiliem na identificação de padrões, tendências e possíveis anomalias nos dados;
- Avaliar a coerência dos registros relacionados às propriedades do concreto, como resistência à compressão, relação água/cimento, abatimento e densidade;
- Produzir informações que possam auxiliar o engenheiro responsável no acompanhamento do controle tecnológico e na tomada de decisões relacionadas à qualidade do concreto.
---
## 📚 Fundamentação Teórica
O processamento e a análise exploratória de dados deste relatório fundamentam-se no ecossistema `tidyverse`, que operacionaliza o ciclo da ciência de dados: importar, organizar, transformar e visualizar [@wickham2023r4ds]. As principais funções utilizadas para o tratamento da base de controle tecnológico do concreto, organizadas de acordo com as etapas do fluxo de trabalho.
**Importação de Dados**
A primeira etapa de qualquer análise é trazer os dados para o R. Para dados tabulares e retangulares, o pacote `readr` fornece funções otimizadas e rápidas [@wickham2023r4ds].
* **`read_csv2()`**: Função projetada especificamente para ler arquivos delimitados por ponto e vírgula (`;`), formato padrão em países onde a vírgula (`,`) é utilizada como separador decimal.
* **`parse_double()`**: Uma função de conversão estrita que força o R a interpretar um vetor de caracteres como números reais (decimais), sendo vital quando erros de digitação forçam colunas numéricas a serem lidas como texto.
**Transformação de Dados**
O pacote `dplyr` fornece a gramática principal para a manipulação dos dados, operando através de verbos que resolvem a grande maioria dos desafios de transformação [@wickham2023r4ds].
* **`filter()`**: Seleciona um subconjunto de linhas com base em condições lógicas (por exemplo, `abatimento_mm > 300`). É a ferramenta principal para isolar valores incompatíveis na base.
* **`select()`**: Reduz a base de dados mantendo apenas as colunas (variáveis) de interesse. Trabalha em conjunto com funções auxiliares de seleção, como **`everything()`** (todas as colunas), **`where(is.numeric)`** (apenas colunas de um tipo específico) e **`all_of()`** (seleção baseada em um vetor externo de strings).
* **`mutate()`**: Cria novas colunas ou modifica colunas existentes operando linha por linha. Foi utilizado para criar as variáveis derivadas de classificação e corrigir grandezas deslocadas.
* **`group_by()`** e **`summarise()`**: A combinação essencial para agregações. O `group_by()` altera o escopo das funções seguintes para operarem por subgrupos (como `tipo_concreto`), enquanto o `summarise()` reduz cada grupo a uma única linha de resumo estatístico (calculando `mean()`, `sd()`, `median()`, `min()` e `max()`).
* **`arrange()`**: Altera a ordem das linhas, permitindo ranquear os resultados, frequentemente auxiliado pela função auxiliar **`desc()`** para forçar a ordem decrescente.
**Vetores Lógicos e Números**
Operações condicionais são necessárias para limpar dados sem afetar a base inteira [@wickham2023r4ds].
* **`if_else()`**: Avalia uma condição lógica vetorizada, retornando um valor se for verdadeira e outro se for falsa. Utilizado para dividir valores de abatimento superestimados de forma condicional.
* **`case_when()`**: Uma generalização do `if_else()` para múltiplas condições aninhadas. Permite classificar os corpos de prova em "Conforme", "Atenção" ou "Não Conforme" com uma sintaxe limpa.
**Strings e Expressões Regulares**
Na prática, dados textuais frequentemente apresentam inconsistências e o pacote `stringr` é utilizado para higienizá-los [@wickham2023r4ds].
* **`str_detect()`**: Retorna um vetor lógico indicando se um padrão textual foi encontrado na string. Fundamental para encontrar caracteres intrusos em colunas numéricas.
* **`str_replace_all()`**: Substitui todas as ocorrências de um padrão por outro. Permitiu trocar vírgulas por pontos e letras por zeros antes da conversão.
* **`str_trim()`**: Remove espaços em branco indesejados no início ou no final do texto, corrigindo erros de digitação invisíveis em categorias textuais.
* **`str_to_upper()`**: Padroniza todos os caracteres para letras maiúsculas, unificando categorias digitadas de formas diferentes.
* Expressões Regulares (Regex): Linguagem concisa para descrever padrões em strings. O uso do padrão `[^0-9.]` exemplifica o poder das regex para encontrar anomalias nos dados numéricos de forma universal.
**Valores Faltantes**
A ausência de informação requer tratamento explícito no R [@wickham2023r4ds].
* **`is.na()`**: Identifica se um valor é estruturalmente ausente (`NA`). É utilizado em conjunto com os filtros textuais e lógicos para diagnosticar perdas de dados sem quebrar as funções matemáticas.
**Iteração e Operações em Colunas**
Para evitar repetição exaustiva de código ao aplicar a mesma transformação matemática a múltiplas propriedades físicas, utilizamos as ferramentas de iteração do `dplyr` [@wickham2023r4ds].
* **`across()`**: Permite aplicar uma função (ou uma lista de funções) a múltiplas colunas simultaneamente. Utilizado dentro de `mutate()` para conversões em massa e dentro de `summarise()` para gerar estatísticas descritivas de todas as propriedades físicas de uma só vez.
**Visualização de Dados**
A análise exploratória visual no R é dominada pelo pacote `ggplot2`, que implementa a gramática dos gráficos através de camadas [@wickham2023r4ds].
* **`ggplot()`**: Inicializa o gráfico e define os mapeamentos estéticos principais através da função auxiliar **`aes()`**, como os eixos x e y.
* **`geom_*()`**: Definem a representação visual dos dados. O **`geom_boxplot()`** revela a distribuição, mediana e outliers da resistência por tipo de concreto. O **`geom_point()`** gera gráficos de dispersão para investigar relações contínuas (tendências), como o impacto do consumo de cimento na resistência final.
---
## ⚙️ Metodologia
A metodologia foi desenvolvida a partir de uma base contendo 100 observações e 10 variáveis relacionadas ao controle tecnológico do concreto. O processamento foi realizado no software R, utilizando principalmente ferramentas da família tidyverse.
Inicialmente, foi realizada a inspeção da estrutura da base, verificando os tipos das variáveis, valores ausentes e possíveis inconsistências. Em seguida, foram investigados erros de digitação, diferenças na escrita das categorias, valores com ordem de grandeza inadequada e problemas na representação de dados numéricos.
Após o diagnóstico, foi criada uma cópia denominada dados_limpos, preservando a base original. Foram realizadas correções e padronizações utilizando funções dos pacotes dplyr, stringr e readr, incluindo a conversão de variáveis para o formato numérico, correção de caracteres e padronização das categorias.
Por fim, os dados tratados foram explorados por meio de estatísticas descritivas e gráficos elaborados com ggplot2, permitindo analisar o comportamento da resistência do concreto e sua relação com outras características da base.
---
## 🔍 Resultados e Discussão
Os resultados obtidos a partir do processamento da base de dados são apresentados e discutidos a seguir, considerando as etapas necessárias. Inicialmente, realizou-se a inspeção e caracterização da base, buscando compreender sua estrutura, suas variáveis e a forma como os dados foram interpretados pelo software R. Em seguida, foram investigadas possíveis inconsistências, valores ausentes e registros potencialmente incompatíveis com o contexto analisado. Após essa etapa de diagnóstico, procedeu-se à limpeza e transformação dos dados, permitindo sua utilização nas análises estatísticas e na elaboração das representações gráficas. Dessa forma, a apresentação dos resultados acompanha a sequência metodológica adotada no código desenvolvido, destacando não apenas os valores obtidos, mas também a interpretação dos resultados e a justificativa das decisões tomadas durante o processamento.
A base de dados reúne informações relacionadas ao controle tecnológico do concreto, permitindo analisar diferentes características dos corpos de prova e das condições em que os ensaios foram realizados, conforme definições a seguir:
- `id_corpo_prova` (identificação do corpo de prova)
- `obra` (Bloco da obra onde ocorreu a concretagem)
- `tipo_concreto` (Classe do Concreto)
- `idade_dias` (Idade do corpo de prova no momento do ensaio)
- `resistencia_mpa`(Resistência à compressão em MPa)
- `cimento_kg_m3`(Consumo de cimento em kg/m³)
- `relacao_a_c` (relação água/cimento)
- `abatimento_mm` (abatimento do concreto, em mm)
- `densidade_kg_m3`(densidade aparente do concreto, em kg/m³)
- `absorção_agregado_pct` (Absorção de água do agregado, em %).
### Conhecendo a base de dados
Inicialmente, foi realizada a importação da base de dados para o ambiente R utilizando recursos da família *tidyverse*, conforme proposto na atividade. A leitura foi realizada por meio da função `read_delim()`, considerando o ponto como separador decimal e o ponto e vírgula como delimitador das colunas. A utilização dessa configuração permitiu a leitura da base sem a necessidade de alterações no arquivo original.
A inspeção inicial, realizada por meio das funções `head()` e `tail()`, permitiu verificar, respectivamente, as primeiras e as últimas observações da base. Observou-se que os registros estão organizados de forma tabular, sendo cada linha correspondente a um corpo de prova e cada coluna associada a uma característica do concreto. Os identificadores dos corpos de prova seguem uma sequência de CP-001 a CP-100, indicando que não foram observadas falhas aparentes na sequência dos registros.
```{r}
library(tidyverse) # Carregamento dos pacotes da família tidyverse

# Importação da base de dados
dados <- read_delim(
  "base_processamento_dados_engenharia_civil.csv",
  delim = ";",
  locale = locale(decimal_mark = "."),
  show_col_types = FALSE
)

head(dados) # Visualiza as primeiras linhas
tail(dados) # Visualiza as útlimas linhas
cat("\nO número de observações e variáveis existentes na base de dados são: \n")
dim (dados) # Número de observações e variáveis existentes na base
```
A aplicação da função `dim()` indicou que a base possui 100 observações e 10 variáveis. Portanto, a estrutura inicial contém informações referentes a 100 registros de controle tecnológico do concreto, distribuídos entre variáveis de identificação, classificação e propriedades físicas e mecânicas.
A função `glimpse()` permitiu analisar de forma detalhada a estrutura da base de dados e verificar os tipos atribuídos pelo R às diferentes variáveis.
```{r}
glimpse(dados) # Estrutura da base
```
Conforme observado, as variáveis *id_corpo_prova*, *obra* e *tipo_concreto* foram reconhecidas como caracteres (`<chr>`), por apresentarem informações de identificação e classificação. A variável *idade_dias* foi identificada como numérica (<dbl>), assim como *abatimento_mm*, *densidade_kg_m3* e *absorção_agregado_pct*. Por outro lado, as variáveis *resistencia_mpa*, *cimento_kg_m3* e *relacao_a_c*, embora representem informações quantitativas, foram inicialmente interpretadas pelo R como caracteres (`<chr>`). Esse resultado indica a existência de possíveis inconsistências na forma de registro desses dados, que deverão ser investigadas nas etapas posteriores, especialmente quanto à representação dos valores numéricos e à necessidade de conversão para o tipo adequado.
A análise dos tipos das variáveis, realizada por meio da função glimpse(), mostrou que o R reconheceu quatro variáveis como quantitativas (<dbl>): idade_dias, abatimento_mm, densidade_kg_m3 e absorção_agregado_pct. As demais foram identificadas como variáveis de caracteres (<chr>), sendo elas id_corpo_prova, obra, tipo_concreto, resistencia_mpa, cimento_kg_m3 e relacao_a_c. Entretanto, a classificação obtida pelo R não corresponde integralmente à natureza das variáveis no contexto da Engenharia Civil. As variáveis resistencia_mpa, cimento_kg_m3 e relacao_a_c representam grandezas quantitativas, mas foram armazenadas como texto na base de dados.
- Resumo das Variáveis (`summary()`)
```{r}
dados |> summary() # resumo das variáveis
# Visualização dos nomes das variáveis.
names(dados)
```
O resumo das variáveis, obtido por meio da função `summary()`, permitiu identificar as principais características descritivas da base e a presença de valores ausentes. A variável *idade_dias* apresentou valores entre 7 e 280 dias, com mediana e média de 28 dias, respectivamente. Para *resistencia_mpa*, foram identificados 83 valores distintos e 1 valor ausente, enquanto *cimento_kg_m3* apresentou 68 valores distintos e *relacao_a_c*, 24 valores distintos, ambas sem valores ausentes. Entre as variáveis numéricas, *abatimento_mm* apresentou valores entre 64 e 1250 mm, com média de 121,7 mm, e *densidade_kg_m3* variou de 238 a 2464 kg/m³, com média de 2351 kg/m³. A variável *absorção_agregado_pct* apresentou valores entre 0,8% e 18,4%, com média de 1,953%, também com um valor ausente. Esses resultados permitem observar, ainda na análise inicial, a existência de valores que apresentam grande dispersão ou magnitude discrepante em relação aos demais registros, os quais deverão ser investigados nas etapas seguintes. Além disso, conforme verificado anteriormente pela função `glimpse()`, as variáveis *resistencia_mpa*, *cimento_kg_m3* e *relacao_a_c* foram interpretadas pelo R como caracteres (`<chr>`), apesar de representarem informações quantitativas, indicando a necessidade de posterior verificação e tratamento dos registros.
- Valores Ausentes
Antes de prosseguir, é importante verificar a existência de valores ausentes (NA) na base de dados, uma vez que sua presença pode comprometer a realização de análises posteriores e influenciar a interpretação dos resultados. Para isso, foram utilizados recursos do `tidyverse` para quantificar os valores ausentes em cada variável e, posteriormente, identificar quais observações apresentam registros incompletos. Essa análise permite avaliar a extensão dos dados faltantes e localizar os registros que deverão ser considerados nas etapas de tratamento e limpeza da base.
```{r}
cat("\nA quantidade de valores ausentes em cada variável existente na base de dados é: \n")
# Quantidade de valores ausentes por variável:
dados |>
  summarise(
    across(
      everything(),
      ~ sum(is.na(.x))
    )
  ) |>
print(width = Inf)
# summarise(): Reduz a base de dados a um resumo estatístico (neste caso, a soma de NAs).
# across(): Permite aplicar a mesma função a múltiplas colunas simultaneamente.
# everything(): Seleciona todas as colunas da base.
# is.na(): Retorna TRUE se o valor for NA (ausente). A soma de TRUEs equivale à contagem de NAs.

cat("\nAs observações onde contêm valores ausentes são: \n")
# Em quais observações aparecem NA
dados |>
  filter(if_any(everything(), is.na)
  ) |>
print(width = Inf)
# filter(): Filtra as linhas da base de dados segundo uma condição lógica.
# if_any(): Verifica se a condição (is.na) é verdadeira para 'qualquer' uma das colunas selecionadas (everything()).
```
De modo geral, a primeira inspeção demonstrou que a base possui uma estrutura organizada, porém não está completamente pronta para a aplicação de análises estatísticas. A identificação das diferenças entre os tipos de dados, dos valores ausentes e das inconsistências nas categorias é fundamental antes da realização dos cálculos e gráficos. Dessa forma, os resultados da Etapa 1 justificam a necessidade das etapas seguintes de investigação, limpeza e transformação dos dados, evitando que erros de registro sejam interpretados como características reais do concreto.
### Investigação da qualidade e consistência dos dados
Após a caracterização inicial da base de dados, iniciou-se a investigação de possíveis problemas de qualidade e consistência dos registros. Nessa fase, buscou-se verificar se os valores presentes na base são compatíveis com o contexto do controle tecnológico do concreto, identificando situações que possam representar erros de digitação, registros inadequados ou valores potencialmente discrepantes.
Nesse processo, foram utilizados principalmente recursos do dplyr, como filter(), select(), count() e distinct(), permitindo localizar e examinar as observações que apresentaram características potencialmente incompatíveis ou inconsistentes. A análise também contemplou a verificação da padronização das categorias das variáveis qualitativas, especialmente obra e tipo_concreto, uma vez que diferentes formas de escrita podem fazer com que registros pertencentes ao mesmo grupo sejam interpretados como categorias distintas pelo R.
Desta forma, inicialmente, analisou-se possíveis erros de digitação (presença de caracteres em dados quantitativos), retornando o seguinte resultado:
```{r}
# QUESTAO 8: Analisando erros de digitação
# filter(): Seleciona as observações (linhas) suspeitas.
# if_any(): Varre múltiplas colunas verificando se 'qualquer' uma contém o erro.
# -(1:3): Exclui as 3 primeiras colunas (id, obra, tipo) da varredura, pois
#         estas são categóricas e naturalmente contêm letras e hifens.
# str_detect(): Função do pacote stringr que avalia a presença do padrão Regex.
# "[^0-9.]": O acento circunflexo (^) nega a busca. Logo, procura tudo que NÃO é dígito/ponto.
# !is.na(.x): Garante que a função ignore os NAs.
# select(): Usamos everything() para atender ao requisito de apresentar o registro completo.
dados |>
  filter(
    if_any(
      -(1:3),
      ~ str_detect(as.character(.x), "[^0-9.]") & !is.na(.x)
    )
  ) |>
  select(everything())
```
Para verificar a existência de valores potencialmente incompatíveis com o contexto da Engenharia Civil, foram estabelecidos critérios de triagem para as principais variáveis analisadas. Foram selecionados registros com idade_dias superior a 100 dias, abatimento_mm superior a 300 mm, densidade_kg_m3 inferior a 2000 kg/m³ ou absorção_agregado_pct superior a 10%. Para as variáveis resistencia_mpa e relacao_a_c, foi realizada uma conversão temporária dos valores, com correção de possíveis registros contendo a letra “O” no lugar do algarismo “0” e substituição da vírgula pelo ponto decimal, permitindo verificar se os valores numéricos resultantes ultrapassavam os limites de 100 MPa e 1,5, respectivamente. Dessa forma, o procedimento permitiu identificar registros que apresentavam valores que merecem investigação mais detalhada, sem alterar, neste momento, os dados originais da base.
```{r}
#| echo: false
dados |>
filter(
idade_dias > 100 |
abatimento_mm > 300 |
densidade_kg_m3 < 2000 |
absorção_agregado_pct > 10 |
# Conversão "on the fly": limpa a leitura apenas neste exato milissegundo
# para sabermos se o valor real por trás da sujeira é absurdo.
parse_double(str_replace_all(resistencia_mpa, c("O" = "0", "," = "."))) > 100 |
parse_double(str_replace_all(relacao_a_c, c("O" = "0", "," = "."))) > 1.5
) |>
# select(): Seleciona as colunas de interesse para facilitar a visualização no relatório.
select(
id_corpo_prova,
idade_dias,
resistencia_mpa,
abatimento_mm,
densidade_kg_m3,
absorção_agregado_pct
)
```
Após a análise dos possíveis valores incompatíveis, foi realizada a verificação das variáveis qualitativas, com o objetivo de identificar inconsistências na padronização das categorias. Essa etapa é importante porque diferenças na forma de escrita, como espaços adicionais ou variações entre letras maiúsculas e minúsculas, podem fazer com que o R interprete registros pertencentes a uma mesma categoria como grupos distintos. Inicialmente, a variável obra foi investigada por meio das funções count() e distinct(), complementadas pela identificação de registros com espaços adicionais. Em seguida, foi analisada a variável tipo_concreto, utilizando distinct() para verificar todas as categorias presentes e identificar possíveis formas diferentes de representação de uma mesma classe de concreto.
```{r}
#| echo: false
# count(): Agrupa os dados pela variável 'obra' e conta o número de observações de cada categoria.
# Facilita a identificação de categorias duplicadas por conta de espaços em branco ou letras minúsculas/maiúsculas.
dados |>
count(obra)
dados |>
distinct(obra)
dados |>
filter(
obra != str_trim(obra)
)
# distinct(): Retorna apenas os valores únicos (sem repetição) presentes na variável 'tipo_concreto'.
# Permite inspecionar rapidamente as variações de categorias existentes na base de dados.
dados |>
distinct(tipo_concreto)
glimpse(dados)
```
A inspeção das categorias qualitativas também revelou algumas particularidades. Na variável obra, foram encontradas cinco categorias distintas, sendo quatro delas aparentemente padronizadas e uma apresentada como “Bloco B ”, contendo espaço adicional ao final do texto. Na variável tipo_concreto, também foram identificadas cinco categorias, embora a base tenha como classes esperadas C25, C30, C35 e C40. A ocorrência de “c30”, em letras minúsculas, indica uma inconsistência de padronização que deverá ser corrigida durante a etapa de limpeza. A necessidade desse tipo de verificação está de acordo com os problemas previstos na atividade, que incluem diferenças na escrita das categorias e espaços adicionais.
### Limpeza e transformação da base de dados
Após a identificação dos possíveis problemas e inconsistências presentes na base, iniciou-se a terceira etapa, destinada à limpeza e transformação dos dados. O objetivo dessa fase foi produzir uma versão da base adequada às análises posteriores, realizando as correções necessárias sem modificar diretamente os dados originais. Para isso, foi criada uma cópia denominada dados_limpos, sobre a qual foram aplicados os procedimentos de padronização das variáveis qualitativas, conversão das variáveis quantitativas para os tipos adequados e tratamento dos valores ausentes. Dessa maneira, buscou-se garantir maior consistência e confiabilidade aos dados antes da realização das análises estatísticas.
```{r}
#| echo: false
# Cópia da base original
# Operador de atribuição (<-) cria uma cópia exata do objeto 'dados'
dados_limpos <- dados
# Padronização das variáveis qualitativas
# mutate(): Substitui as colunas existentes pelas suas versões tratadas.
# str_trim(): Remove os espaços acidentais no início e no final do texto.
# str_to_upper(): Converte todas as letras para maiúsculas (ex: 'c30' vira 'C30').
# str_replace_all(): Troca hifens por 'nada', padronizando 'C-30' para 'C30'.
dados_limpos <- dados_limpos |>
mutate(
obra = str_trim(obra),
tipo_concreto = str_to_upper(str_trim(str_replace_all(tipo_concreto, "-", "")))
)
# Conversão Numérica e Correção de Grandezas
# Coluna 4 à 10 os dados devem ser numéricos. Primeiro, limpamos erros de digitação (letras e vírgulas) e forçamos a conversão. Depois, aplicamos a lógica de engenharia para corrigir as grandezas que o read_csv2 multiplicou ou dividiu acidentalmente por interpretar o ponto como milhar
# Passo 1: Limpeza de texto e conversão
dados_limpos <- dados_limpos |>
mutate(
# across(): Aplica a cadeia de funções em múltiplas colunas simultaneamente.
# -(1:3): Seleciona todas as colunas da base, EXCETO as 3 primeiras (id, obra, tipo).
across(
-(1:3),
# Função anônima (~): Converte para texto, arruma e converte de volta para número.
~ as.character(.x) |>
str_replace_all(c("O" = "0", "," = ".")) |>
parse_double()
)
) |>
# Passo 2: Correção Matemática das grandezas (casas decimais deslocadas)
mutate(
# if_else(): Se a condição for TRUE, aplica o primeiro cálculo; se FALSE, mantém original.
# Abatimentos lidos como 1110 ou 1250 são divididos por 10 (retornando a 111 e 125)
abatimento_mm = if_else(abatimento_mm > 300, abatimento_mm / 10, abatimento_mm),
# Densidades lidas como 238 ou 245 recebem um 0 (multiplicado por 10) para 2380, etc.
densidade_kg_m3 = if_else(densidade_kg_m3 < 1000, densidade_kg_m3 * 10, densidade_kg_m3),
# Se o consumo for absurdamente alto (maior que 1000), divide por 10.
cimento_kg_m3 = if_else(cimento_kg_m3 > 1000, cimento_kg_m3 / 10, cimento_kg_m3),
# Absorções lidas como 18.4 ou 23.0 são divididas por 10 (voltando a 1.84 e 2.30)
absorção_agregado_pct = if_else(absorção_agregado_pct > 10, absorção_agregado_pct / 10, absorção_agregado_pct),
# Idade de 280 dias causada por digitação extra do zero volta a ser 28
idade_dias = if_else(idade_dias > 200, idade_dias / 10, idade_dias)
)
glimpse(dados_limpos)
```
A criação de uma cópia da base original, denominada *dados_limpos*, tem por objetivo realizar os procedimentos de tratamento sem alterar os dados inicialmente importados. Essa decisão é importante porque preservar a base original permite manter os registros brutos como referência, possibilitando comparar os dados antes e depois do tratamento, revisar eventuais decisões de correção e evitar a perda das informações originalmente fornecidas. Assim, qualquer alteração realizada durante o processamento pode ser rastreada e, caso necessário, revisada.
Na sequência, foram padronizadas as variáveis qualitativas. Na variável obra, foram removidos espaços adicionais por meio de `str_trim()`. Para tipo_concreto, além da remoção de espaços, foram convertidas as letras para maiúsculas com `str_to_upper()` e eliminados os hífens por meio de `str_replace_all()`, permitindo uniformizar categorias como c30 e C-30 para uma mesma representação, C30.
Posteriormente, foi realizada a conversão das variáveis quantitativas que haviam sido inicialmente reconhecidas como caracteres. Com o uso de `across()` e funções de tratamento textual do stringr, foram corrigidas possíveis ocorrências da letra “O” no lugar do algarismo “0” e substituídas as vírgulas por pontos antes da conversão para valores numéricos. Após essa conversão, foram aplicadas correções específicas às variáveis que apresentavam casas decimais ou ordens de grandeza deslocadas. Os valores de abatimento_mm superiores a 300 foram divididos por 10; valores de densidade_kg_m3 inferiores a 1000 foram multiplicados por 10; valores de absorção_agregado_pct superiores a 10 foram divididos por 10; e valores de idade_dias superiores a 200 foram divididos por 10. Essas transformações tiveram como finalidade recuperar a grandeza considerada adequada para cada variável, com base nos problemas identificados na etapa anterior.
Ao final do procedimento, o `glimpse(dados_limpos)` mostrou que as variáveis quantitativas passaram a ser reconhecidas pelo R como numéricas (`<dbl>`), enquanto *id_corpo_prova*, *obra* e *tipo_concreto* permaneceram como variáveis de caracteres (`<chr>`). Dessa forma, a base passou a apresentar uma estrutura mais adequada para as etapas seguintes de análise e exploração dos dados.
- Identificação e tratamento dos valores ausentes
```{r}
#| echo: false
# Tratamento de Valores Ausentes (NA): Visualizamos os NAs para decidir como agir. Em Engenharia Civil, inferir a resistência de um concreto ausente (substituindo pela média, por exemplo) pode mascarar uma falha estrutural. O mais seguro é manter o NA ou excluir
# filter() e is.na(): Visualiza as linhas que ainda possuem NA após a limpeza.
dados_limpos |> filter(if_any(everything(), is.na))
```
Após uma nova verificação dos valores ausentes o resultado identificou cinco registros contendo valores ausentes, correspondentes aos corpos de prova CP-015, CP-038, CP-077, CP-092 e CP-097. Os valores ausentes ocorreram, respectivamente, em diferentes variáveis da base: abatimento_mm no CP-015, relacao_a_c no CP-038, densidade_kg_m3 no CP-077, resistencia_mpa no CP-092 e absorção_agregado_pct no CP-097.
Diante desses registros, optou-se por manter os valores ausentes (NA) na base, não sendo realizada a exclusão das observações nem a substituição dos valores por estimativas, como a média. Essa decisão foi adotada porque o preenchimento de uma informação não registrada poderia introduzir um valor artificial e interferir na interpretação dos resultados. Além disso, a ausência de uma variável não implica necessariamente que todas as demais informações daquele corpo de prova sejam inválidas. Dessa forma, os registros serão preservados e os valores disponíveis poderão continuar sendo utilizados nas análises em que forem pertinentes, enquanto os NA deverão ser considerados pelos procedimentos estatísticos que envolvam especificamente as variáveis com dados ausentes.
A opção por consultar a fonte original dos dados também seria uma alternativa adequada para situações em que fosse possível recuperar os registros faltantes. Entretanto, considerando o procedimento adotado nesta atividade, não foi realizada essa recuperação, mantendo-se os NA para preservar a informação efetivamente disponível na base.
```{r}
#| echo: false
# Questão 16: Verificação final da estrutura
# glimpse(): Confirma que agora as 3 primeiras colunas são <chr> e as demais são <dbl>.
cat("--- Estrutura (Glimpse) ---\n")
glimpse(dados_limpos)
# summary(): Demonstra que os limites extremos (ex: máximo de 1250 no abatimento)
# desapareceram, retornando à escala física normal.
cat("\n--- Resumo Estatístico ---\n")
summary(dados_limpos)
```
Após a aplicação dos procedimentos de limpeza e transformação, a estrutura e o resumo estatístico da base foram novamente verificados por meio das funções `glimpse()` e `summary()`.
As correções das grandezas produziram alterações importantes nos valores extremos. Na base original, foram identificados valores máximos de 280 dias para *idade_dias*, 1250 mm para *abatimento_mm*, 2464 kg/m³ para *densidade_kg_m3* e 18,4% para *absorção_agregado_pct*, sendo alguns desses valores indicativos de possíveis erros de registro. Após a limpeza, os valores máximos passaram para 56 dias, 175 mm, 2464 kg/m³ e 2,92%, respectivamente. Essas alterações estão diretamente relacionadas às correções aplicadas durante o processamento, corrigindo registros para valores compatíveis com a ordem de grandeza esperada.
Após essas transformações, os valores mínimos e máximos apresentados pela base passaram a apresentar maior coerência com os demais registros de um conjunto de dados de controle tecnológico do concreto, indicando que os principais problemas de registro identificados nas etapas anteriores foram efetivamente tratados.
### Exploração dos dados
Com a base `dados_limpos` devidamente estruturada e tratada, iniciou-se a etapa voltada à exploração e análise descritiva dos dados.
```{r}
#| echo: false
# Questão 17: Resistência média
cat("\nResistência média dos Corpos de Prova:")
# summarise(): Reduz os dados a um único resumo estatístico.
# na.rm = TRUE: Argumento essencial. Ignora os NAs para que o cálculo da média não resulte em erro.
dados_limpos |>
summarise(resistencia_media_geral = mean(resistencia_mpa, na.rm = TRUE))
cat("\nResistência média à compressão agrupada por bloco da obra:")
# Média por Bloco (Obra)
# group_by(): Divide a base de dados em "pacotes" (grupos) baseados na variável categórica.
dados_limpos |>
group_by(obra) |>
summarise(resistencia_media = mean(resistencia_mpa, na.rm = TRUE))
cat("\nResistência média agrupada por tipo de concreto:")
# Média por Tipo de Concreto
dados_limpos |>
group_by(tipo_concreto) |>
summarise(resistencia_media = mean(resistencia_mpa, na.rm = TRUE))
cat("\nResistência média à compressão agrupada por idade dos corpos de prova:")
# Média por Idade
dados_limpos |>
group_by(idade_dias) |>
summarise(resistencia_media = mean(resistencia_mpa, na.rm = TRUE))
# Comparação entre obras
cat("\nComparação do desempenho entre os blocos da obra\n")
cat("Para descobrir qual bloco teve o melhor e o pior desempenho, agrupamos por")
cat("obra, calculamos a média e ordenamos do maior para o menor.\n")
# arrange(): Ordena as linhas de um data frame com base em uma coluna.
# desc(): Força a ordenação de forma decrescente (do maior para o menor valor).
dados_limpos |>
group_by(obra) |>
summarise(resistencia_media = mean(resistencia_mpa, na.rm = TRUE)) |>
arrange(desc(resistencia_media))
cat("\nAnálise:\n")
cat("Ao observar o tibble gerado, o primeiro bloco da lista apresenta a maior")
cat("resistência média, enquanto o último apresenta a menor.\n")
# Questão 19: Tipo de concreto
cat("\nAnálise de desempenho por Classe de Concreto\n")
cat("Verificação se os concretos com maior classe nominal (ex: C40) de fato")
cat("apresentaram a maior resistência média na prática.\n")
dados_limpos |>
group_by(tipo_concreto) |>
summarise(resistencia_media = mean(resistencia_mpa, na.rm = TRUE)) |>
arrange(desc(resistencia_media))
cat("\nAnálise:\n")
cat("A classe C40 deve encabeçar a lista por ter a maior resistência especificada.\n")
cat("A ordenação descrescente comprova se a hierarquia técnica (C40 > C35 > C30 > C25)\n")
cat("foi mantida durante a execução da obra.\n\n")
# Questão 20: Estatísticas por grupo (Múltiplas Variáveis)
cat("\nEstatísticas médias das propriedades físicas por tipo de concreto\n")
cat("As principais variáveis tecnológicas foram agrupadas para interpretar como a dosagem\n")
cat("se comporta conforme a classe do concreto aumenta.\n\n")
# O summarise() permite realizar múltiplos cálculos simultaneamente dentro do mesmo comando.
# Substitui o uso do antigo aggregate() da Base R, sendo mais intuitivo e flexível.
dados_limpos |>
group_by(tipo_concreto) |>
summarise(
media_resistencia = mean(resistencia_mpa, na.rm = TRUE),
media_cimento = mean(cimento_kg_m3, na.rm = TRUE),
media_relacao_ac = mean(relacao_a_c, na.rm = TRUE),
media_abatimento = mean(abatimento_mm, na.rm = TRUE),
media_densidade = mean(densidade_kg_m3, na.rm = TRUE)
) |>
arrange(desc(media_resistencia))
cat("\nInterpretação Técnica dos Resultados:\n")
cat("- O consumo de cimento aumenta nas classes mais altas (C40) e a relação")
cat(" água/cimento diminui. Esse é o comportamento técnico correto e esperado,")
cat(" pois menos água e mais cimento aumentam a resistência da matriz.")
cat("- A densidade costuma se manter estável (em torno de 2350-2450 kg/m3),")
cat(" indicando que os agregados e o adensamento foram padronizados.")
```
### Criação de novas variáveis
Após a exploração das características da base por meio de estatísticas descritivas e agrupamentos, iniciou-se a etapa destinada à criação de novas variáveis a partir dos dados já tratados. Nessa etapa, utilizou-se principalmente a função `mutate()`, em conjunto com `case_when()` e outras operações do `dplyr`, para gerar informações derivadas que possibilitem uma interpretação mais aprofundada dos resultados.
As novas variáveis foram construídas com o propósito de relacionar a resistência observada dos corpos de prova com referências associadas às diferentes classes de concreto e, também, de classificar e comparar os registros segundo critérios definidos para a análise. Dessa forma, a utilização de variáveis derivadas permite ampliar as informações disponíveis na base sem modificar os dados originais, facilitando a identificação de padrões e a interpretação do desempenho dos corpos de prova
- Variável Resistência Relativa: representa a razão entre a resistência observada e uma resistência de referência associada à classe do concreto.
```{r}
#| echo: false
# Questão 21: Resistência relativa - A resistência de referência é a resistência característica (fck) que dá nome à classe do concreto (ex: C25 exige referência de 25 MPa). Utilizamos a função case_when() para mapear cada classe ao seu respectivo valor e, em seguida, calculamos a razão entre o valor ensaiado e essa referência.
# mutate(): Adiciona novas colunas à base de dados.
# case_when(): Avalia uma sequência de condições (como um if_else encadeado).
# A estrutura é `condição ~ valor_se_verdadeiro`.
dados_limpos <- dados_limpos |>
mutate(
resistencia_referencia = case_when(
tipo_concreto == "C25" ~ 25,
tipo_concreto == "C30" ~ 30,
tipo_concreto == "C35" ~ 35,
tipo_concreto == "C40" ~ 40,
TRUE ~ NA_real_ # Valor padrão caso encontre uma classe não mapeada
),
# A razão mostra o quão acima (valores > 1) ou abaixo (valores < 1) da meta estamos
resistencia_relativa = resistencia_mpa / resistencia_referencia
)
```
A resistência de referência foi definida a partir da resistência característica (fck) correspondente à classe do concreto, utilizando diretamente o valor indicado na própria nomenclatura da classe. Assim, foram adotados 25 MPa para C25, 30 MPa para C30, 35 MPa para C35 e 40 MPa para C40. Essa referência foi utilizada posteriormente para calcular a resistência relativa de cada corpo de prova.
- Variável Classificação: classifica os corpos de prova segundo um critério relacionado à resistência.
Os critérios de classificação foram definidos tomando como referência a resistência característica (fck) correspondente à classe de cada concreto. Os corpos de prova cuja resistência obtida foi maior ou igual à resistência de referência foram classificados como “Conforme”. Quando a resistência ficou até 10% abaixo da referência, adotou-se a classificação “Atenção”, indicando a necessidade de acompanhamento do resultado. Valores mais de 10% abaixo da referência foram classificados como “Não Conforme”, por representarem um afastamento mais significativo em relação ao valor de referência. Nos casos em que a resistência não estava disponível, adotou-se a categoria “Sem Dado”, evitando atribuir uma classificação sem informação suficiente.
```{r}
#| echo: false
# Questão 22: Classificação de corpos de prova
cat("Critérios técnicos definidos com base na resistência de referência:\n")
cat("- 'Conforme': Resistência obtida é maior ou igual à de referência.\n")
cat("- 'Atenção': Resistência caiu até 10% abaixo da referência.\n")
cat("- 'Não Conforme': Resistência caiu mais de 10% abaixo da referência (risco estrutural).\n\n")
dados_limpos <- dados_limpos |>
mutate(
classificacao = case_when(
resistencia_mpa >= resistencia_referencia ~ "Conforme",
resistencia_mpa >= 0.90 * resistencia_referencia ~ "Atenção",
resistencia_mpa < 0.90 * resistencia_referencia ~ "Não Conforme",
is.na(resistencia_mpa) ~ "Sem Dado"
)
)
```
- Variável `acima_media`: indica se a resistência do corpo de prova está acima ou abaixo da resistência média de seu respectivo tipo de concreto. A variável assume os seguintes valores: TRUE ou FALSE
```{r}
#| echo: false
# Questão 23: Variável acima_media - Para calcular se a amostra está acima da média de sua classe sem precisar calcular os valores manualmente, combinamos group_by() com mutate(). Isso força a função mean() a calcular a média internamente para cada bloco de concreto.
# group_by(): Diz ao R para realizar as próximas operações separando a base por classe.
# mutate(): Executa o teste lógico (>). O resultado será TRUE ou FALSE.
# ungroup(): Função crítica após agrupar para criar colunas. Ela "desagrupa" a base,
# garantindo que as futuras análises (Etapa 6) não fiquem presas a esse agrupamento.
dados_limpos <- dados_limpos |>
group_by(tipo_concreto) |>
mutate(
acima_media = resistencia_mpa > mean(resistencia_mpa, na.rm = TRUE)
) |>
ungroup()
cat("Visualizando o resultado das novas variáveis criadas (primeiros registros):\n")
# select(): Utilizado aqui apenas para focar nas colunas recém-criadas na impressão.
dados_limpos |>
select(
id_corpo_prova,
tipo_concreto,
resistencia_mpa,
resistencia_relativa,
classificacao,
acima_media
) |>
head() |>
print(width = Inf)
```
### Dados agrupados
- Número de observações por Tipo de Concreto: quantidade de corpos de prova para cada classe de concreto
```{r}
#| echo: false
# Questão 24: Contagem de observações por grupo
# group_by(): Cria os grupos virtuais baseados na classe do concreto.
# summarise(): Consolida a informação.
# n(): Função específica do dplyr que conta o número de linhas (observações) dentro de cada grupo.
dados_limpos |>
group_by(tipo_concreto) |>
summarise(quantidade_observacoes = n())
```
- Resistência média de cada tipo de concreto ordenada em ordem decrescente
```{r}
#| echo: false
# Questão 25: Resistência média ordenada
dados_limpos |>
group_by(tipo_concreto) |>
summarise(resistencia_media = mean(resistencia_mpa, na.rm = TRUE)) |>
arrange(desc(resistencia_media))
```
- Resumo Estatístico para os tipos de Concreto
```{r}
#| echo: false
# Questão 26: Resumo estatístico descritivo simultâneo
# sum(!is.na(resistencia_mpa)): Forma inteligente de contar observações ignorando os NAs.
dados_limpos |>
group_by(tipo_concreto) |>
summarise(
n_observacoes = sum(!is.na(resistencia_mpa)),
media = mean(resistencia_mpa, na.rm = TRUE),
mediana = median(resistencia_mpa, na.rm = TRUE),
desvio_padrao = sd(resistencia_mpa, na.rm = TRUE),
minimo = min(resistencia_mpa, na.rm = TRUE),
maximo = max(resistencia_mpa, na.rm = TRUE),
.groups = "drop" # Boa prática: remove o agrupamento residual no objeto resultante
)
```
Uma tabela que apresenta várias estatísticas é mais informativa do que uma tabela contendo apenas a média porque permite avaliar não apenas o valor central dos resultados, mas também a variabilidade e a dispersão dos dados. Na Engenharia Civil, a média isolada pode ocultar diferenças importantes entre os corpos de prova. Por exemplo, uma classe de concreto pode apresentar média de resistência superior ao seu valor de referência, mas, ao mesmo tempo, possuir elevado desvio-padrão e valores mínimos significativamente inferiores. A análise conjunta da média, mediana, desvio-padrão, mínimo e máximo permite, portanto, avaliar melhor a uniformidade dos resultados e a ocorrência de valores extremos, proporcionando uma interpretação mais completa do comportamento da resistência do concreto e contribuindo para uma avaliação mais adequada do controle tecnológico.
### Seleção e Organização de variáveis
As propriedades físicas correspondem às variáveis numéricas:
```{r}
#| echo: false
# Questão 27: Seleção de variáveis quantitativas
# Definindo um vetor com os nomes exatos das colunas desejadas
variaveis_quantitativas <- c(
"idade_dias", "resistencia_mpa", "cimento_kg_m3",
"relacao_a_c", "abatimento_mm", "densidade_kg_m3", "absorção_agregado_pct"
)
# select(): Escolhe colunas específicas.
# all_of(): Garante que a seleção utilize estritamente os nomes contidos no vetor externo.
dados_propriedades <- dados_limpos |>
select(all_of(variaveis_quantitativas))
cat("Visualização da nova tabela (apenas propriedades físicas):\n")
head(dados_propriedades)
# Questão 28: Média simultânea com across()
cat("\nQuestão 28: Média das variáveis quantitativas utilizando across()\n")
# summarise(): Consolida os dados.
# across(): Aplica a mesma função (~ mean) em todas as colunas selecionadas (everything()).
dados_propriedades |>
summarise(
across(
everything(),
~ mean(.x, na.rm = TRUE)
)
)
```
Comparação de abordagem: A utilização de `across()` torna o código mais simples e eficiente, pois evita a necessidade de utilizar `summarise()` individualmente para cada variável. Nesse caso, seria necessário escrever sete linhas de código, uma para cada variável analisada, enquanto o uso de across() permite realizar a mesma operação de forma conjunta. Essa abordagem também facilita a manutenção do código, especialmente quando o número de variáveis aumenta, como em bases contendo diversas propriedades obtidas em ensaios de laboratório.
Para atender à necessidade de realizar uma transformação simultânea nas variáveis quantitativas, foram criadas novas variáveis centralizadas em relação à média de cada propriedade. A transformação consiste em subtrair a média da respectiva variável de cada observação, permitindo identificar se determinado resultado está acima ou abaixo do comportamento médio da base. A utilização de mutate() em conjunto com across() possibilitou aplicar o procedimento simultaneamente às diferentes propriedades do concreto, sem alterar os valores originais.
```{r}
#| echo: false
# Questão 29: Transformação simultânea (mutate + across)
# mutate(): Altera colunas existentes.
# across(): Varre todas as colunas (everything()) e aplica a função de arredondamento.
dados_limpos <- dados_limpos |>
mutate(
across(
c(resistencia_mpa,
cimento_kg_m3,
relacao_a_c,
abatimento_mm,
densidade_kg_m3,
absorção_agregado_pct),
~ .x - mean(.x, na.rm = TRUE),
.names = "{.col}_centrada"
)
)
# Questão 30: Múltiplas estatísticas com across()
# group_by(): Agrupa pelo tipo de concreto (necessário usar a base 'dados_limpos').
# across(): Aplica a lista de funções (media e dp) às colunas quantitativas.
# .names: Formata o nome das novas colunas de saída automaticamente.
dados_limpos |>
group_by(tipo_concreto) |>
summarise(
across(
all_of(variaveis_quantitativas),
list(
media = ~ mean(.x, na.rm = TRUE),
dp = ~ sd(.x, na.rm = TRUE)
),
.names = "{.col}_{.fn}"
),
.groups = "drop"
) |>
# Selecionando apenas algumas colunas para a impressão caber na tela
select(tipo_concreto, resistencia_mpa_media, resistencia_mpa_dp, abatimento_mm_media, abatimento_mm_dp)
```
A utilização de across(), como observado acima, permite aplicar simultaneamente diferentes funções estatísticas às variáveis quantitativas, evitando a necessidade de escrever comandos separados para cada uma delas. Nesse caso, uma lista de funções pode ser fornecida ao across(), possibilitando obter, por exemplo, a média e o desvio-padrão de cada variável para cada tipo de concreto. Essa abordagem torna o código mais compacto, organizado e padronizado, além de facilitar sua manutenção quando novas variáveis forem acrescentadas à base. Comparativamente à elaboração de vários comandos individuais, o procedimento reduz a repetição do código e diminui a possibilidade de erros de digitação ou de aplicação inconsistente das mesmas operações entre as diferentes variáveis.
O uso de across() torna o procedimento mais eficiente, pois a mesma transformação é aplicada a todas as variáveis selecionadas sem a necessidade de escrever cada operação individualmente.
30
Para obter as estatísticas das variáveis quantitativas de acordo com o tipo de concreto, foi utilizada a combinação das funções group_by(), summarise() e across(). A função group_by() permitiu separar os registros conforme as classes de concreto, enquanto summarise() foi utilizada para resumir os dados. Por meio de across(), foram calculadas simultaneamente a média e o desvio padrão para todas as variáveis armazenadas no vetor variaveis_concreto.
A média foi utilizada para representar o valor central de cada variável, enquanto o desvio padrão permitiu avaliar a dispersão dos valores dentro de cada tipo de concreto. Os valores ausentes (NA) foram desconsiderados por meio do argumento na.rm = TRUE.
A utilização de across() apresenta maior facilidade de manutenção em comparação com vários comandos separados. Em uma abordagem individual, seria necessário escrever uma expressão para cada variável e para cada estatística. Com across(), as mesmas operações são aplicadas automaticamente a todas as variáveis selecionadas. Assim, caso novas variáveis quantitativas sejam adicionadas ao vetor variaveis_concreto, elas serão incluídas nos cálculos sem a necessidade de modificar o comando principal.
O resultado é apresentado de forma organizada, com uma linha para cada tipo de concreto e colunas correspondentes à média e ao desvio padrão de cada variável quantitativa.
```{r}
#| echo: false
# Questão 31: Verificação e padronização da variável obra
# str_trim(): Remove espaços em branco no início e no final dos textos.
# str_to_upper(): Padroniza todos os textos utilizando letras maiúsculas.
# str_squish(): Remove espaços duplicados dentro dos textos.
# str_replace_all(): Permite corrigir grafias diferentes que representam a mesma categoria.
# Antes da padronização
dados_limpos |>
distinct(obra) |>
arrange(obra)
# Padronização da variável obra
dados_limpos <- dados_limpos |>
mutate(
obra = str_trim(obra),
obra = str_squish(obra),
obra = str_to_upper(obra),
obra = str_replace_all(obra, "OBRA 01", "OBRA 1"),
obra = str_replace_all(obra, "OBRA 02", "OBRA 2"),
obra = str_replace_all(obra, "OBRA 03", "OBRA 3")
)
# Depois da padronização
dados_limpos |>
distinct(obra) |>
arrange(obra)
```
Para verificar e padronizar a variável obra, foram utilizadas funções do pacote stringr. Inicialmente, foi realizada a identificação das categorias existentes por meio de distinct(), permitindo observar possíveis diferenças de grafia, utilização de letras maiúsculas e minúsculas e espaços desnecessários.
Para a padronização, foi utilizada a função str_trim(), responsável por remover espaços no início e no final dos textos. Em seguida, str_squish() foi utilizada para eliminar espaços duplicados, enquanto str_to_upper() padronizou todos os valores para letras maiúsculas.
Também foi utilizada str_replace_all() para corrigir possíveis diferenças de grafia entre categorias que representam a mesma obra. Dessa forma, os valores passaram a apresentar um padrão único, facilitando agrupamentos, filtros e análises posteriores.
A comparação entre os resultados antes e depois da padronização permite verificar as alterações realizadas na variável obra. Após o tratamento, categorias que apresentavam apenas diferenças de formatação ou grafia passam a ser representadas de maneira consistente, reduzindo o risco de uma mesma obra ser considerada como categorias diferentes durante as análises.
```{r}
#| echo: false
# Questão 32: Localização de padrões textuais
# str_detect(): Verifica se um determinado padrão de texto está presente em uma variável.
# regex(): Permite utilizar padrões de busca de forma mais flexível.
# A busca será realizada por registros cujo tipo de concreto contenha "C30",
# permitindo localizar também possíveis diferenças de formatação, como "c30".
# Busca pelo padrão "C30" na variável tipo_concreto
dados_limpos |>
filter(
str_detect(
tipo_concreto,
regex("C30", ignore_case = TRUE)
)
) |>
select(
id_corpo_prova,
obra,
tipo_concreto,
resistencia_mpa
)
```
Para localizar registros que contenham determinado padrão textual, foi utilizada a função str_detect() do pacote stringr. A condição de busca escolhida foi a identificação dos registros da classe C30 na variável tipo_concreto. Foi utilizada a função regex() com ignore_case = TRUE, permitindo localizar tanto C30 quanto possíveis variações de letras maiúsculas e minúsculas, como c30.
A utilização de padrões de texto é importante para o diagnóstico de bases de dados porque permite identificar rapidamente inconsistências de preenchimento, diferenças de formatação, categorias duplicadas e possíveis erros de digitação. Esse tipo de verificação é especialmente útil antes da realização de agrupamentos e análises estatísticas, pois valores aparentemente iguais podem ser tratados como categorias diferentes quando apresentam grafias distintas.
No caso desta base, a busca pelo padrão C30 permite verificar se existem registros dessa classe e se há alguma variação na forma como ela foi registrada. Dessa maneira, o uso de str_detect() contribui para a identificação de problemas de padronização e para o aumento da qualidade e confiabilidade dos dados.
```{r}
#| echo: false
# Questão 33: Distribuição da resistência à compressão por tipo de concreto
# ggplot(): Define a base de dados e os mapeamentos estéticos do gráfico.
# geom_boxplot(): Representa a distribuição dos valores por meio da mediana,
# quartis, dispersão e possíveis valores discrepantes.
# na.rm = TRUE: Remove da representação os registros com resistência ausente.
dados_limpos |>
ggplot(
aes(
x = tipo_concreto,
y = resistencia_mpa
)
) +
geom_boxplot(na.rm = TRUE) +
labs(
title = "Distribuição da resistência à compressão por tipo de concreto",
x = "Tipo de concreto",
y = "Resistência à compressão (MPa)"
) +
theme_minimal()
```
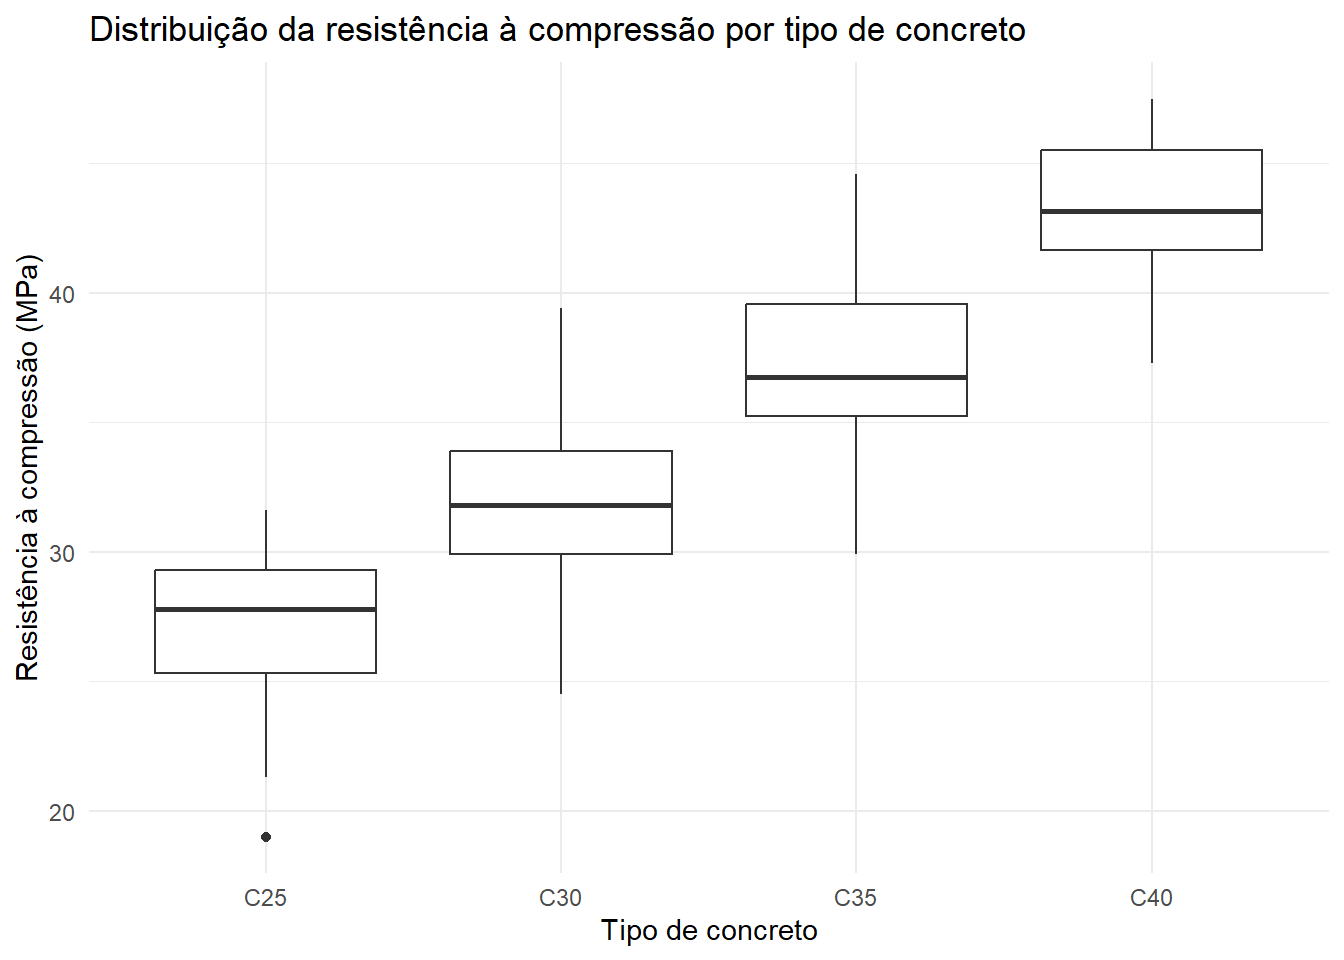
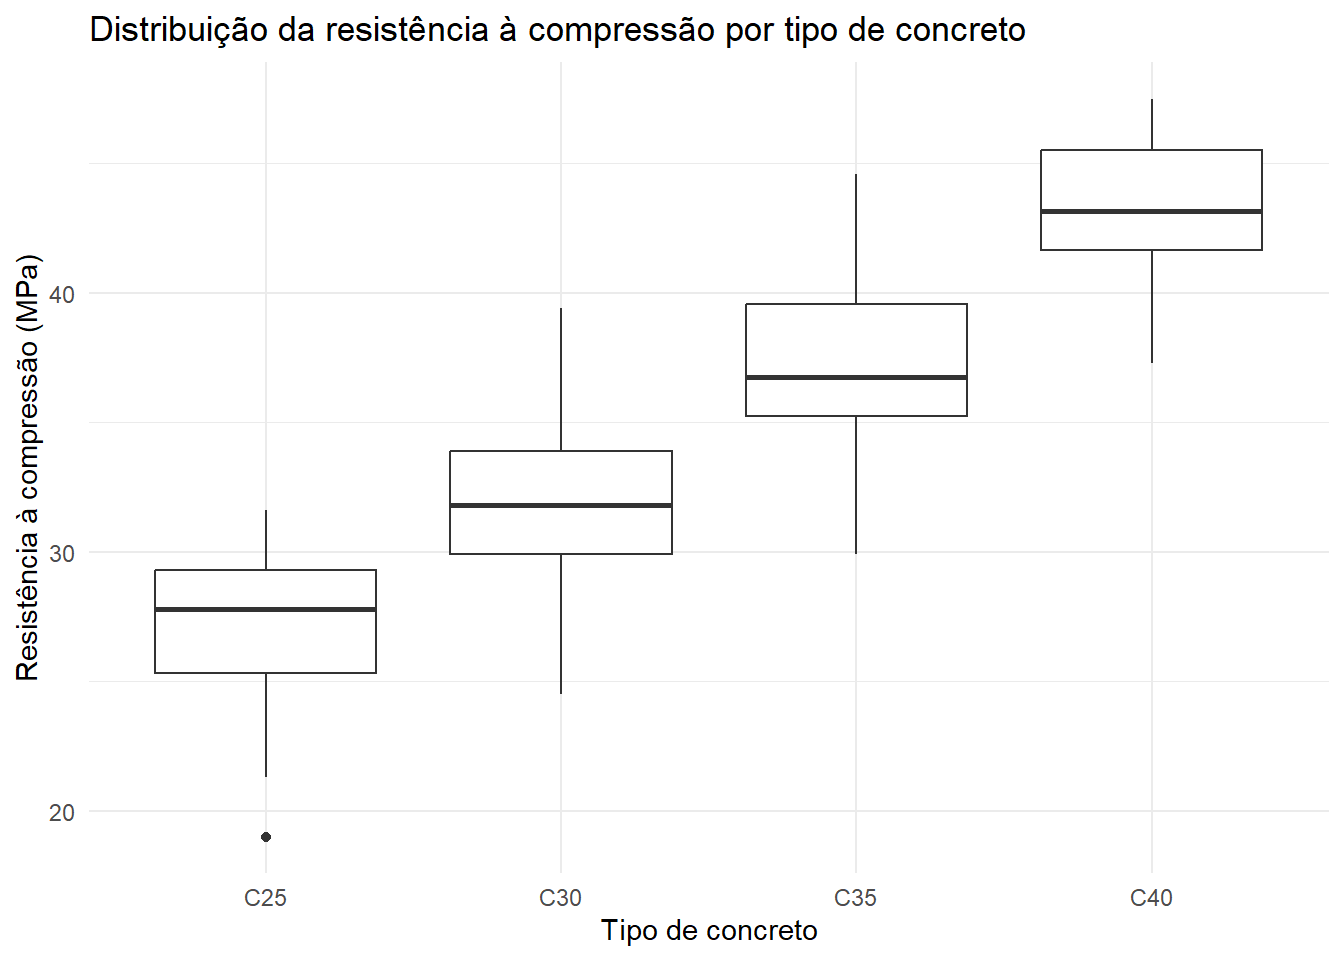
Para comparar a distribuição da resistência à compressão entre os diferentes tipos de concreto, foi utilizado um gráfico de caixas, construído com a função geom_boxplot() do pacote ggplot2. Essa representação permite visualizar, para cada classe de concreto, a mediana, a dispersão dos resultados, os quartis e possíveis valores discrepantes.
A comparação entre as caixas permite verificar se as classes de concreto apresentam diferenças em relação aos valores centrais de resistência e à variabilidade dos resultados. Espera-se que as classes de maior resistência nominal, como C35 e C40, apresentem valores de resistência superiores aos observados nas classes C25 e C30. Além disso, caixas mais altas ou com maior amplitude indicam maior dispersão dos resultados, enquanto caixas mais concentradas indicam maior uniformidade entre os corpos de prova.
Dessa forma, o gráfico permite avaliar visualmente tanto o desempenho das diferentes classes de concreto quanto a variabilidade dos resultados obtidos no controle tecnológico.
```{r}
#| echo: false
# Questão 34: Relação entre consumo de cimento e resistência à compressão
# ggplot(): Define a base de dados e os mapeamentos do gráfico.
# geom_point(): Representa cada corpo de prova como um ponto no gráfico.
# geom_smooth(): Adiciona uma linha de tendência para facilitar a identificação
# da relação entre o consumo de cimento e a resistência à compressão.
# method = "lm": Utiliza um modelo de regressão linear para representar a tendência.
# na.rm = TRUE: Desconsidera registros com valores ausentes.
dados_limpos |>
ggplot(
aes(
x = cimento_kg_m3,
y = resistencia_mpa
)
) +
geom_point(na.rm = TRUE) +
geom_smooth(
method = "lm",
se = TRUE,
na.rm = TRUE
) +
labs(
title = "Relação entre consumo de cimento e resistência à compressão",
x = "Consumo de cimento (kg/m³)",
y = "Resistência à compressão (MPa)"
) +
theme_minimal()
```
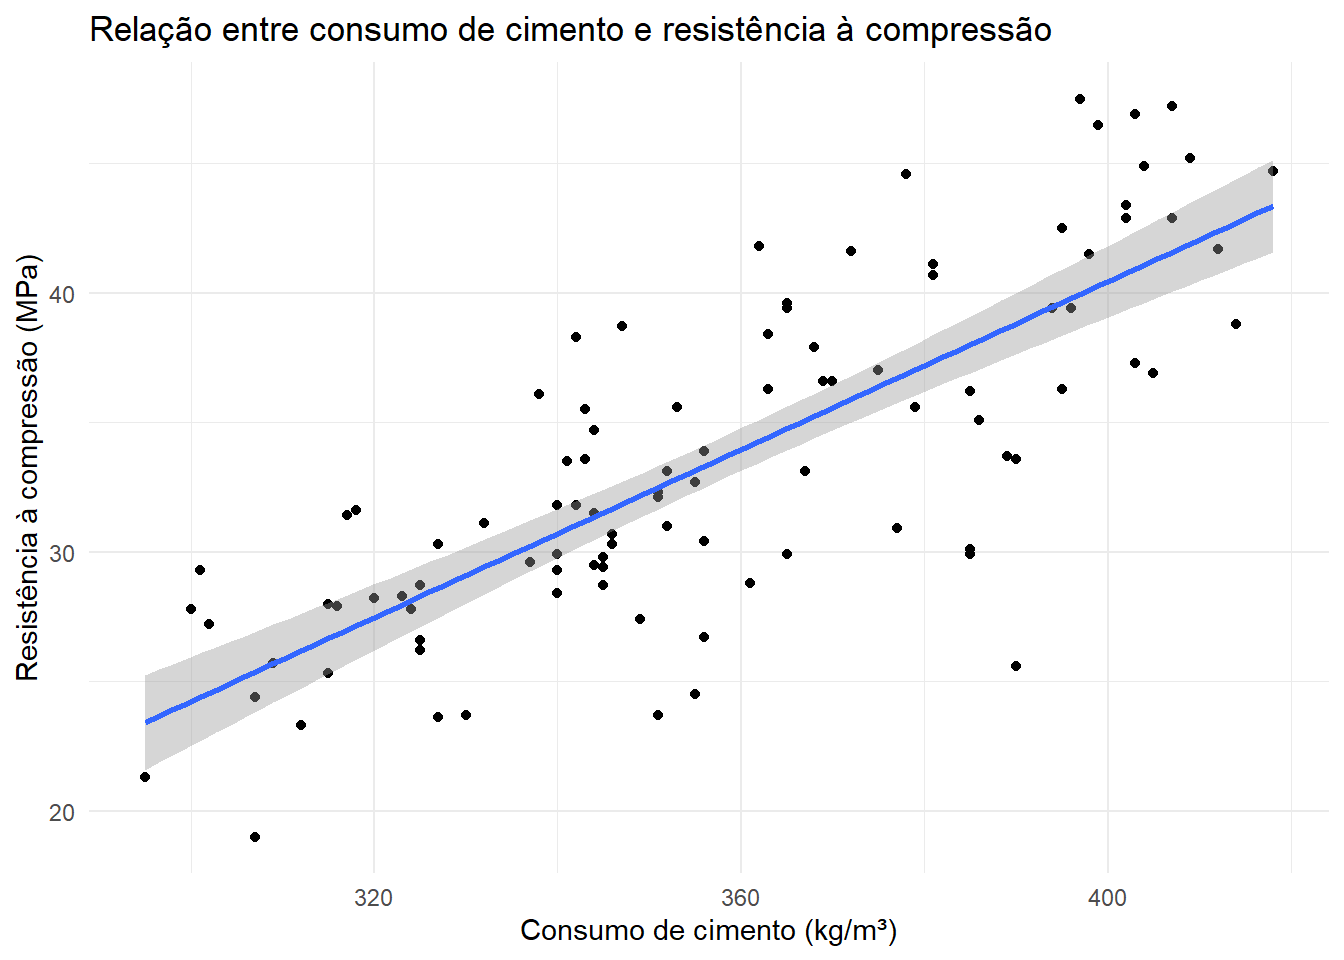
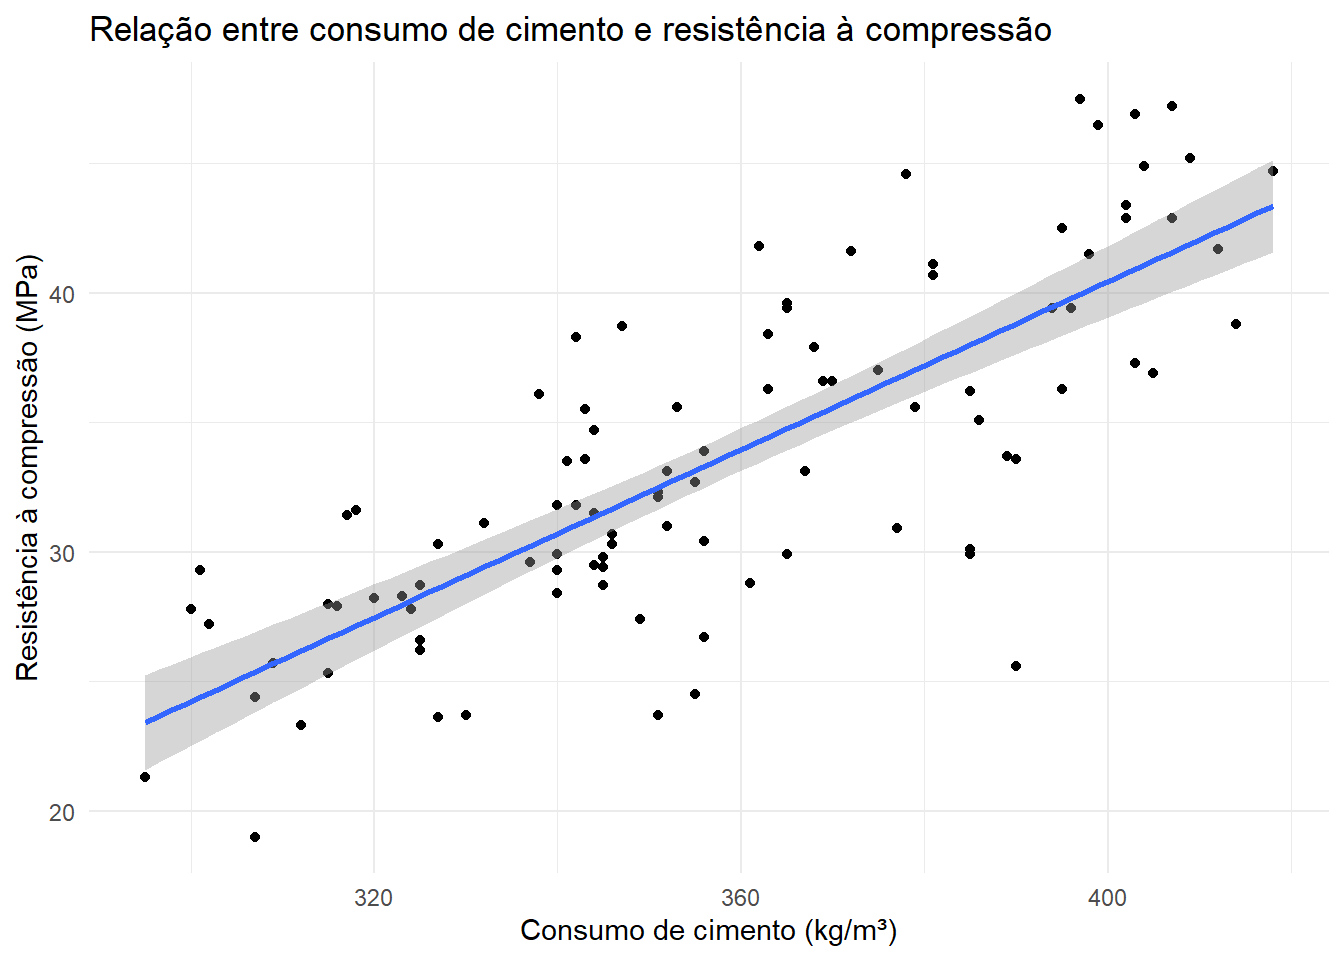
O gráfico de dispersão foi utilizado para investigar visualmente a relação entre o consumo de cimento e a resistência à compressão do concreto. Cada ponto representa uma observação da base de dados, enquanto a linha de tendência foi adicionada por meio de geom_smooth() com um modelo de regressão linear.
A análise visual do gráfico permite verificar se existe uma tendência de aumento da resistência à compressão à medida que o consumo de cimento aumenta. Caso os pontos apresentem uma concentração crescente ao longo da linha de tendência, há uma evidência visual de associação positiva entre as duas variáveis.
Entretanto, o gráfico, por si só, não permite afirmar que o maior consumo de cimento seja a causa do aumento da resistência. A resistência do concreto também pode ser influenciada por outros fatores, como a relação água/cimento, tipo de cimento, idade do corpo de prova e características dos agregados.
Assim, o gráfico pode fornecer evidência visual compatível com a afirmação “quanto maior o consumo de cimento, maior tende a ser a resistência do concreto” caso seja observada uma tendência positiva, mas essa conclusão deve ser complementada por uma análise estatística da correlação ou do modelo de regressão.
```{r}
#| echo: false
# Questão 35: Relação entre relação água/cimento e resistência à compressão
# ggplot(): Define a base de dados e os mapeamentos do gráfico.
# geom_point(): Representa cada corpo de prova como um ponto no gráfico.
# geom_smooth(): Adiciona uma linha de tendência para facilitar a identificação
# do comportamento entre as variáveis.
# method = "lm": Utiliza uma regressão linear para representar a tendência.
# na.rm = TRUE: Desconsidera registros com valores ausentes.
dados_limpos |>
ggplot(
aes(
x = relacao_a_c,
y = resistencia_mpa
)
) +
geom_point(na.rm = TRUE) +
geom_smooth(
method = "lm",
se = TRUE,
na.rm = TRUE
) +
labs(
title = "Relação entre relação água/cimento e resistência à compressão",
x = "Relação água/cimento",
y = "Resistência à compressão (MPa)"
) +
theme_minimal()
```
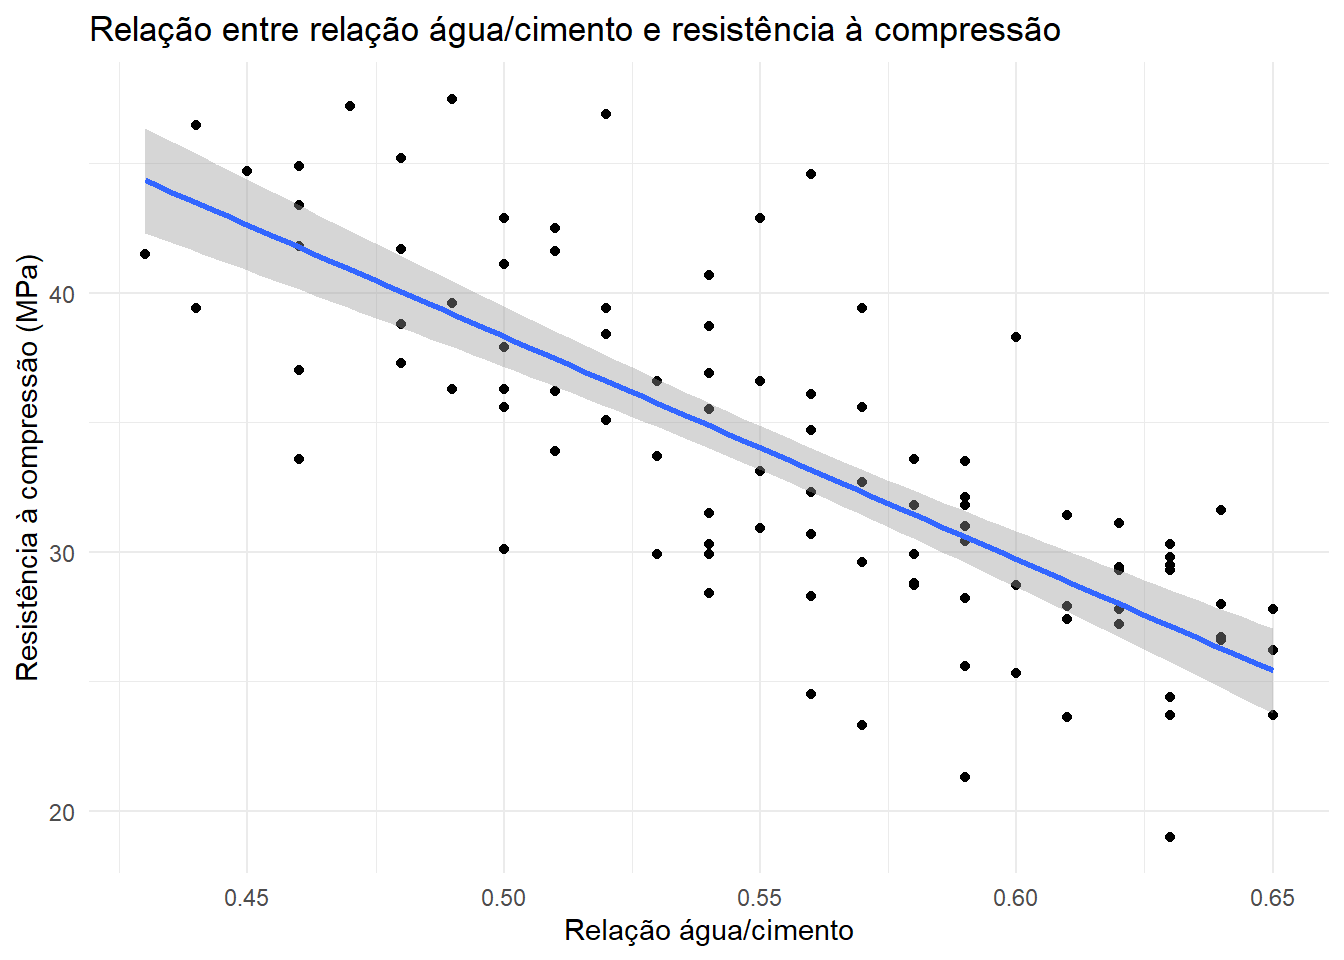
O gráfico de dispersão foi utilizado para investigar a relação entre a relação água/cimento e a resistência à compressão dos corpos de prova. A linha de tendência foi adicionada para facilitar a identificação do comportamento geral dos dados.
A análise do gráfico permite investigar se existe uma tendência de redução da resistência à compressão à medida que a relação água/cimento aumenta. Esse comportamento é esperado tecnicamente, pois uma maior quantidade de água em relação ao cimento pode resultar em uma estrutura mais porosa após a hidratação, contribuindo para a redução da resistência.
Nos dados analisados, caso os pontos apresentem uma tendência descendente, haverá uma evidência visual de associação negativa entre a relação água/cimento e a resistência à compressão. Entretanto, a dispersão dos pontos também deve ser observada, pois indica que outros fatores podem influenciar a resistência.
Portanto, a relação observada merece investigação, principalmente para verificar a intensidade dessa associação e identificar possíveis observações que se afastem do comportamento geral. Uma análise de correlação ou um modelo de regressão poderia complementar a interpretação visual apresentada pelo gráfico.
```{r}
#| echo: false
# Questão 36: Comparação do desempenho dos concretos entre as obras
# group_by(): Organiza os dados de acordo com a obra.
# summarise(): Calcula estatísticas descritivas da resistência à compressão.
# arrange(): Ordena os resultados da maior para a menor resistência média.
# ggplot(): Permite representar graficamente a distribuição dos resultados.
# geom_boxplot(): Facilita a comparação da distribuição da resistência entre as obras.
# na.rm = TRUE: Desconsidera os valores ausentes.
# Comparação descritiva da resistência à compressão entre as obras
comparacao_obras <- dados_limpos |>
group_by(obra) |>
summarise(
n_observacoes = sum(!is.na(resistencia_mpa)),
media = mean(resistencia_mpa, na.rm = TRUE),
mediana = median(resistencia_mpa, na.rm = TRUE),
desvio_padrao = sd(resistencia_mpa, na.rm = TRUE),
.groups = "drop"
) |>
arrange(desc(media))
comparacao_obras
# Gráfico da distribuição da resistência por obra
dados_limpos |>
ggplot(
aes(
x = obra,
y = resistencia_mpa
)
) +
geom_boxplot(na.rm = TRUE) +
labs(
title = "Comparação da resistência à compressão entre as obras",
x = "Obra",
y = "Resistência à compressão (MPa)"
) +
theme_minimal()
```
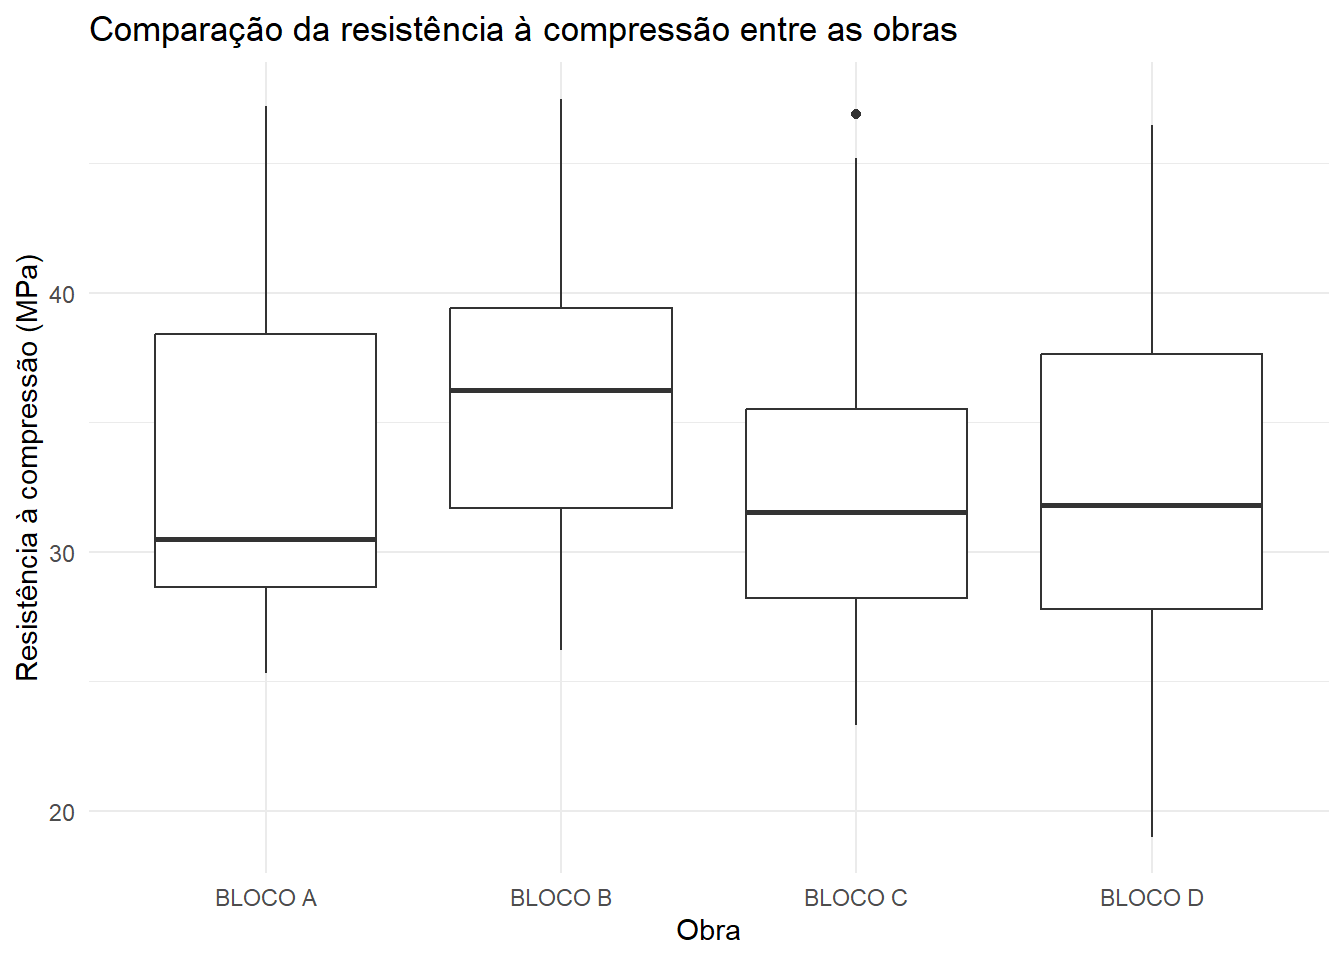
A comparação foi realizada de forma descritiva, utilizando a média, a mediana e o desvio padrão da resistência à compressão para cada obra. Também foi elaborado um gráfico de caixas para permitir uma comparação visual da distribuição dos resultados.
Com base nos dados, o Bloco C não apresenta a maior resistência média. A resistência média observada foi de aproximadamente 32,37 MPa, enquanto os Blocos A, B e D apresentaram médias de aproximadamente 33,19 MPa, 35,90 MPa e 32,39 MPa, respectivamente.
Portanto, os dados não dão suporte, em termos descritivos, à afirmação de que os concretos utilizados no Bloco C apresentam desempenho superior aos demais blocos. O Bloco B apresentou a maior resistência média, enquanto o Bloco C apresentou uma média ligeiramente inferior à dos Blocos A e D.
A análise também mostra que a resistência apresenta variabilidade dentro de cada obra. Assim, embora a comparação das médias seja útil para uma primeira avaliação, outros fatores, como a classe do concreto, a relação água/cimento e a idade dos corpos de prova, também devem ser considerados antes de atribuir diferenças de desempenho exclusivamente à obra.
```{r}
#| echo: false
# Questão 37: Relação entre idade e resistência à compressão
# group_by(): Organiza os dados de acordo com a idade dos corpos de prova.
# summarise(): Calcula a resistência média para cada idade.
# arrange(): Organiza os resultados em ordem crescente de idade.
# ggplot(): Define a base de dados e os mapeamentos do gráfico.
# geom_point(): Representa as médias de resistência para cada idade.
# geom_line(): Liga os pontos, facilitando a visualização da tendência.
# na.rm = TRUE: Desconsidera os valores ausentes.
resistencia_por_idade <- dados_limpos |>
group_by(idade_dias) |>
summarise(
n_observacoes = sum(!is.na(resistencia_mpa)),
resistencia_media = mean(resistencia_mpa, na.rm = TRUE),
.groups = "drop"
) |>
arrange(idade_dias)
resistencia_por_idade
# Gráfico da resistência média em função da idade
resistencia_por_idade |>
ggplot(
aes(
x = idade_dias,
y = resistencia_media
)
) +
geom_point() +
geom_line() +
labs(
title = "Resistência média à compressão em função da idade",
x = "Idade do corpo de prova (dias)",
y = "Resistência média à compressão (MPa)"
) +
theme_minimal()
```
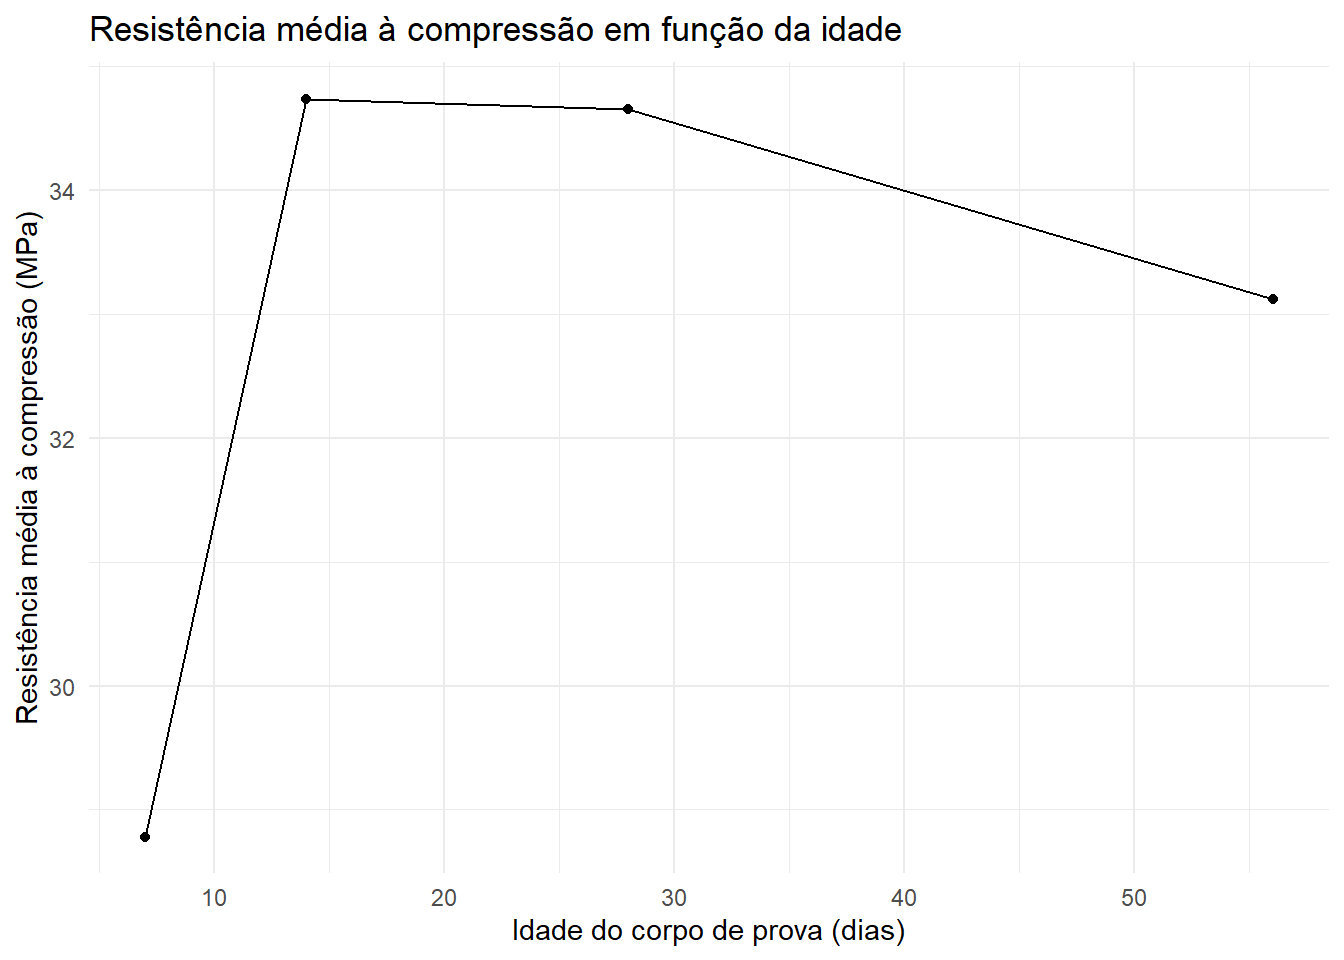
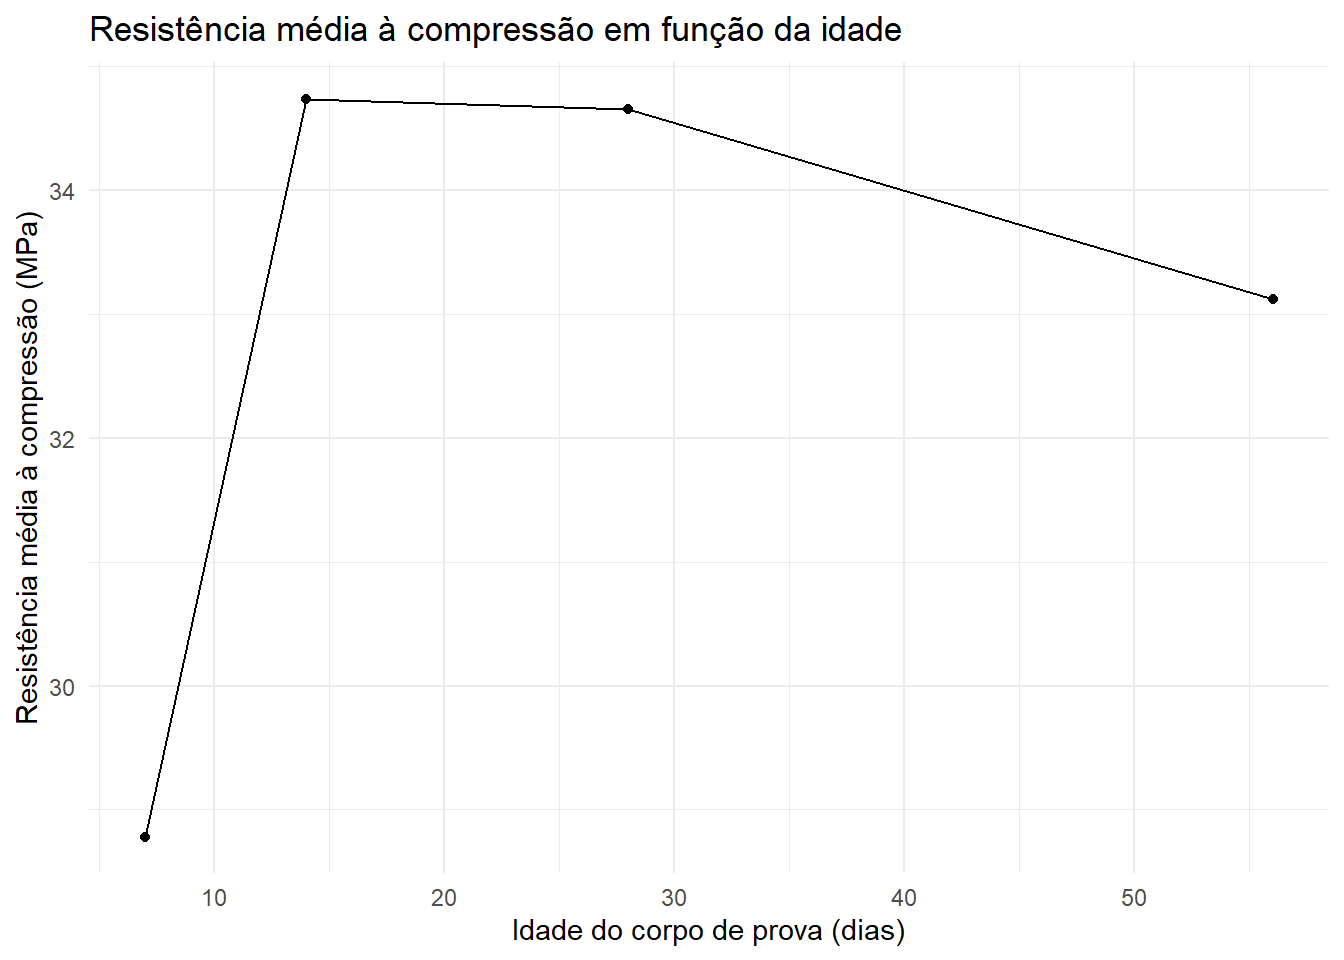
A resistência média à compressão foi comparada entre as diferentes idades dos corpos de prova. Para isso, foram utilizadas as funções group_by() e summarise(), permitindo calcular a média da resistência para cada idade. Em seguida, foi utilizado um gráfico com pontos e linhas para facilitar a visualização do comportamento dos resultados.
Na base analisada, a resistência média foi de aproximadamente 28,78 MPa aos 7 dias, aumentando para 34,74 MPa aos 14 dias. Aos 28 dias, a média foi de aproximadamente 34,67 MPa, mantendo-se praticamente no mesmo nível observado aos 14 dias. Aos 56 dias, foi observada uma média de aproximadamente 33,12 MPa.
Assim, os dados indicam um aumento da resistência entre 7 e 14 dias, seguido de relativa estabilidade entre 14 e 28 dias e uma pequena redução da média aos 56 dias. Portanto, embora exista uma tendência geral de aumento da resistência com o avanço da idade nas primeiras idades, os dados não apresentam crescimento contínuo em todas as idades.
Essa variação merece investigação, pois a resistência do concreto normalmente tende a aumentar com a idade, especialmente nas primeiras idades. A presença de diferenças entre os resultados pode estar relacionada à variabilidade dos corpos de prova e a outros fatores, como classe do concreto, relação água/cimento e condições de produção e cura.
```{r}
#| echo: false
# Questão 38: Tabela-resumo para acompanhamento da qualidade do concreto
# group_by(): Organiza os dados por tipo de concreto.
# summarise(): Calcula as principais estatísticas para o acompanhamento da qualidade.
# n(): Informa a quantidade de registros de cada classe.
# mean(): Calcula a resistência média dos corpos de prova.
# median(): Apresenta a mediana da resistência, reduzindo a influência de valores extremos.
# sd(): Mede a variabilidade dos resultados de resistência.
# min() e max(): Apresentam os menores e maiores valores observados.
# na.rm = TRUE: Desconsidera os valores ausentes nos cálculos.
resumo_qualidade <- dados_limpos |>
group_by(tipo_concreto) |>
summarise(
n_observacoes = sum(!is.na(resistencia_mpa)),
resistencia_media = mean(resistencia_mpa, na.rm = TRUE),
resistencia_mediana = median(resistencia_mpa, na.rm = TRUE),
desvio_padrao = sd(resistencia_mpa, na.rm = TRUE),
resistencia_minima = min(resistencia_mpa, na.rm = TRUE),
resistencia_maxima = max(resistencia_mpa, na.rm = TRUE),
.groups = "drop"
) |>
arrange(desc(resistencia_media))
resumo_qualidade
```
Para o acompanhamento da qualidade do concreto, foi construída uma tabela-resumo por tipo de concreto contendo seis informações estatísticas consideradas relevantes: número de observações, resistência média, mediana, desvio padrão, resistência mínima e resistência máxima.
A quantidade de observações foi incluída para verificar o volume de dados disponível para cada classe de concreto. A resistência média permite avaliar o desempenho médio dos corpos de prova e comparar as diferentes classes. A mediana complementa a média e permite identificar o comportamento central dos dados com menor influência de valores extremos.
O desvio padrão foi utilizado para avaliar a variabilidade dos resultados. Valores mais elevados indicam maior dispersão das resistências, podendo sinalizar menor uniformidade no controle tecnológico. As resistências mínima e máxima permitem identificar a amplitude dos resultados e possíveis valores que mereçam uma investigação mais detalhada.
A utilização do group_by() em conjunto com summarise() permite que todas essas informações sejam calculadas simultaneamente para cada tipo de concreto. Dessa forma, a tabela fornece ao engenheiro uma visão geral e organizada do desempenho e da variabilidade das diferentes classes, auxiliando no acompanhamento da qualidade do concreto.
### Desafio Final
``` {r}
# ============================================================
# DESAFIO FINAL — O ENGENHEIRO RESPONSÁVEL PELOS DADOS
# Controle tecnológico do concreto
# ============================================================

# ============================================================
# ETAPA 1 — CARREGAMENTO DOS PACOTES E DA BASE
# ============================================================

library(tidyverse)

# Importação da base de dados
dados <- read_csv2(
  "base_processamento_dados_engenharia_civil.csv",
  locale = locale(decimal_mark = "."),
  show_col_types = FALSE
)

# Inspeção inicial da estrutura da base
glimpse(dados)
# Visualização das primeiras observações
dados |>
  slice_head(n = 10)
# ============================================================
# ETAPA 2 — INSPEÇÃO E IDENTIFICAÇÃO DE POSSÍVEIS PROBLEMAS
# ============================================================

# Verificação das categorias existentes em tipo_concreto
dados |>
  count(tipo_concreto, sort = TRUE)
# Verificação das categorias existentes em obra
dados |>
  count(obra, sort = TRUE)
# Verificação de possíveis diferenças de preenchimento em obra
dados |>
  distinct(obra) |>
  arrange(obra)
# Identificação de valores ausentes em cada variável
dados |>
  summarise(
    across(
      everything(),
      ~ sum(is.na(.x))
    )
  )
# Localização dos registros que apresentam algum valor ausente
dados |>
  filter(
    if_any(
      everything(),
      is.na
    )
  )
# ============================================================
# ETAPA 3 — LIMPEZA E PADRONIZAÇÃO DOS DADOS
# ============================================================

dados_limpos <- dados |>
  mutate(
    # Padronização dos textos da variável obra
    obra = str_trim(obra),
    obra = str_squish(obra),

    # Padronização da classe do concreto
    tipo_concreto = str_trim(tipo_concreto),
    tipo_concreto = str_to_upper(tipo_concreto),
    tipo_concreto = str_replace_all(tipo_concreto, "-", "")
  ) |>
  mutate(
    # Conversão das variáveis quantitativas para formato numérico.
    # A substituição de "O" por "0" corrige possíveis erros de digitação.
    across(
      -(1:3),
      ~ as.character(.x) |>
        str_replace_all("O", "0") |>
        str_replace_all(",", ".") |>
        parse_double()
    )
  )


# ============================================================
# ETAPA 4 — CORREÇÃO DE VALORES INCONSISTENTES
# ============================================================

# Algumas observações apresentam valores incompatíveis com
# as unidades esperadas. As correções abaixo procuram recuperar
# a escala provável dos dados sem alterar os valores que já
# estavam dentro de uma faixa coerente.

dados_limpos <- dados_limpos |>
  mutate(
    # Valores de abatimento acima de 300 mm são interpretados
    # como erro de escala.
    abatimento_mm = if_else(
      abatimento_mm > 300,
      abatimento_mm / 10,
      abatimento_mm
    ),

    # Valores de densidade abaixo de 1000 kg/m³ são interpretados
    # como erro de escala.
    densidade_kg_m3 = if_else(
      densidade_kg_m3 < 1000,
      densidade_kg_m3 * 10,
      densidade_kg_m3
    ),

    # Valores de consumo de cimento acima de 1000 kg/m³
    # são interpretados como erro de escala.
    cimento_kg_m3 = if_else(
      cimento_kg_m3 > 1000,
      cimento_kg_m3 / 10,
      cimento_kg_m3
    ),

    # Valores de absorção acima de 10% são tratados como
    # possível erro de escala.
    absorção_agregado_pct = if_else(
      absorção_agregado_pct > 10,
      absorção_agregado_pct / 10,
      absorção_agregado_pct
    ),

    # Idades muito elevadas são verificadas como possível
    # erro de digitação/escala.
    idade_dias = if_else(
      idade_dias > 200,
      idade_dias / 10,
      idade_dias
    )
  )


# ============================================================
# ETAPA 5 — VERIFICAÇÃO DA BASE APÓS A LIMPEZA
# ============================================================

glimpse(dados_limpos)
# Verificação das classes de concreto após a padronização
dados_limpos |>
  count(tipo_concreto, sort = TRUE)
# Verificação dos valores ausentes após o tratamento
dados_limpos |>
  summarise(
    across(
      everything(),
      ~ sum(is.na(.x))
    )
  )
# ============================================================
# ETAPA 6 — ESTATÍSTICAS DESCRITIVAS GERAIS
# ============================================================

resumo_geral <- dados_limpos |>
  summarise(
    n_observacoes = sum(!is.na(resistencia_mpa)),
    resistencia_media = mean(resistencia_mpa, na.rm = TRUE),
    resistencia_mediana = median(resistencia_mpa, na.rm = TRUE),
    desvio_padrao = sd(resistencia_mpa, na.rm = TRUE),
    resistencia_minima = min(resistencia_mpa, na.rm = TRUE),
    resistencia_maxima = max(resistencia_mpa, na.rm = TRUE)
  )

resumo_geral
# ============================================================
# ETAPA 7 — ESTATÍSTICAS POR TIPO DE CONCRETO
# ============================================================

resumo_classes <- dados_limpos |>
  group_by(tipo_concreto) |>
  summarise(
    n_observacoes = sum(!is.na(resistencia_mpa)),
    resistencia_media = mean(resistencia_mpa, na.rm = TRUE),
    resistencia_mediana = median(resistencia_mpa, na.rm = TRUE),
    desvio_padrao = sd(resistencia_mpa, na.rm = TRUE),
    resistencia_minima = min(resistencia_mpa, na.rm = TRUE),
    resistencia_maxima = max(resistencia_mpa, na.rm = TRUE),
    .groups = "drop"
  ) |>
  arrange(desc(resistencia_media))

resumo_classes
# ============================================================
# ETAPA 8 — PRIMEIRA VARIÁVEL DERIVADA
# RESISTÊNCIA DE REFERÊNCIA E RESISTÊNCIA RELATIVA
# ============================================================

# A resistência de referência foi definida de acordo com a
# classe nominal do concreto:
# C25 = 25 MPa
# C30 = 30 MPa
# C35 = 35 MPa
# C40 = 40 MPa

dados_limpos <- dados_limpos |>
  mutate(
    resistencia_referencia = case_when(
      tipo_concreto == "C25" ~ 25,
      tipo_concreto == "C30" ~ 30,
      tipo_concreto == "C35" ~ 35,
      tipo_concreto == "C40" ~ 40,
      TRUE ~ NA_real_
    ),

    # Razão entre a resistência observada e a resistência
    # de referência da respectiva classe.
    resistencia_relativa =
      resistencia_mpa / resistencia_referencia
  )


# ============================================================
# ETAPA 9 — SEGUNDA VARIÁVEL DERIVADA
# CLASSIFICAÇÃO DO RESULTADO
# ============================================================

dados_limpos <- dados_limpos |>
  mutate(
    classificacao = case_when(
      is.na(resistencia_mpa) ~ "Sem Dado",
      resistencia_mpa >= resistencia_referencia ~ "Conforme",
      resistencia_mpa >= 0.90 * resistencia_referencia ~ "Atenção",
      resistencia_mpa < 0.90 * resistencia_referencia ~ "Não Conforme"
    )
  )

# Quantidade de registros por classificação
dados_limpos |>
  count(classificacao, sort = TRUE)
# ============================================================
# ETAPA 10 — ANÁLISE DO COMPORTAMENTO POR OBRA
# ============================================================

comparacao_obras <- dados_limpos |>
  group_by(obra) |>
  summarise(
    n_observacoes = sum(!is.na(resistencia_mpa)),
    resistencia_media = mean(resistencia_mpa, na.rm = TRUE),
    resistencia_mediana = median(resistencia_mpa, na.rm = TRUE),
    desvio_padrao = sd(resistencia_mpa, na.rm = TRUE),
    .groups = "drop"
  ) |>
  arrange(desc(resistencia_media))

comparacao_obras
# ============================================================
# ETAPA 11 — ANÁLISE DA IDADE E RESISTÊNCIA
# ============================================================

resistencia_por_idade <- dados_limpos |>
  group_by(idade_dias) |>
  summarise(
    n_observacoes = sum(!is.na(resistencia_mpa)),
    resistencia_media = mean(resistencia_mpa, na.rm = TRUE),
    .groups = "drop"
  ) |>
  arrange(idade_dias)

resistencia_por_idade
# ============================================================
# ETAPA 12 — GRÁFICO 1
# DISTRIBUIÇÃO DA RESISTÊNCIA POR TIPO DE CONCRETO
# ============================================================

dados_limpos |>
  ggplot(
    aes(
      x = tipo_concreto,
      y = resistencia_mpa
    )
  ) +
  geom_boxplot(na.rm = TRUE) +
  labs(
    title = "Distribuição da resistência à compressão por tipo de concreto",
    x = "Tipo de concreto",
    y = "Resistência à compressão (MPa)"
  ) +
  theme_minimal()
# ============================================================
# ETAPA 13 — GRÁFICO 2
# RELAÇÃO ENTRE CONSUMO DE CIMENTO E RESISTÊNCIA
# ============================================================

dados_limpos |>
  ggplot(
    aes(
      x = cimento_kg_m3,
      y = resistencia_mpa
    )
  ) +
  geom_point(na.rm = TRUE) +
  geom_smooth(
    method = "lm",
    se = TRUE,
    na.rm = TRUE
  ) +
  labs(
    title = "Relação entre consumo de cimento e resistência à compressão",
    x = "Consumo de cimento (kg/m³)",
    y = "Resistência à compressão (MPa)"
  ) +
  theme_minimal()
# ============================================================
# ETAPA 14 — GRÁFICO 3
# RELAÇÃO ENTRE IDADE E RESISTÊNCIA MÉDIA
# ============================================================

resistencia_por_idade |>
  ggplot(
    aes(
      x = idade_dias,
      y = resistencia_media
    )
  ) +
  geom_point() +
  geom_line() +
  labs(
    title = "Resistência média à compressão em função da idade",
    x = "Idade do corpo de prova (dias)",
    y = "Resistência média à compressão (MPa)"
  ) +
  theme_minimal()
# ============================================================
# ETAPA 15 — INFORMAÇÕES PARA AUXILIAR O ENGENHEIRO
# ============================================================

# Percentual de registros em cada classificação
informacoes_engenheiro <- dados_limpos |>
  count(classificacao) |>
  mutate(
    percentual = n / sum(n) * 100
  ) |>
  arrange(desc(n))

informacoes_engenheiro
# Resistência média e quantidade de resultados por obra
dados_limpos |>
  group_by(obra) |>
  summarise(
    n_observacoes = sum(!is.na(resistencia_mpa)),
    resistencia_media = mean(resistencia_mpa, na.rm = TRUE),
    .groups = "drop"
  ) |>
  arrange(desc(resistencia_media))
# Identificação dos registros classificados como "Não Conforme"
dados_limpos |>
  filter(classificacao == "Não Conforme") |>
  select(
    id_corpo_prova,
    obra,
    tipo_concreto,
    idade_dias,
    resistencia_mpa,
    resistencia_referencia,
    resistencia_relativa,
    classificacao
  )
# ============================================================
# ETAPA 16 — TABELA FINAL PARA O RELATÓRIO
# ============================================================

tabela_final <- dados_limpos |>
  select(
    id_corpo_prova,
    obra,
    tipo_concreto,
    idade_dias,
    resistencia_mpa,
    cimento_kg_m3,
    relacao_a_c,
    abatimento_mm,
    densidade_kg_m3,
    absorção_agregado_pct,
    resistencia_referencia,
    resistencia_relativa,
    classificacao
  )

tabela_final
```
**Reflexão final**
A principal diferença entre utilizar Base R e a família tidyverse está na forma de organizar e expressar as operações de processamento. O Base R oferece funções mais tradicionais e flexíveis, enquanto o tidyverse apresenta uma estrutura mais padronizada, na qual funções como filter(), select(), mutate(), summarise() e group_by() permitem construir uma sequência de transformação dos dados de maneira mais legível. Além disso, ferramentas como across(), stringr, tidyr e ggplot2 facilitam a aplicação das mesmas operações a várias variáveis, o tratamento de textos, a reorganização dos dados e a produção de gráficos.
O processamento e a limpeza dos dados são etapas fundamentais antes da aplicação de métodos estatísticos na Engenharia Civil porque resultados incorretos ou inconsistentes podem comprometer diretamente a interpretação do desempenho dos materiais. Erros de digitação, unidades incorretas, categorias duplicadas e valores ausentes precisam ser identificados antes da análise para evitar conclusões equivocadas e fornecer informações confiáveis para a tomada de decisões técnicas.
O principal problema identificado na base foi a presença de inconsistências de preenchimento e de escala, incluindo diferenças na forma de registrar categorias, valores numéricos incompatíveis com as unidades esperadas e registros ausentes. Como decisão de tratamento, os textos foram padronizados e os valores que apresentavam indícios claros de erro de escala foram corrigidos de acordo com a unidade esperada, enquanto os valores ausentes foram mantidos como NA, evitando a criação de valores artificiais.
Foram utilizadas principalmente funções da família tidyverse, como read_csv2(), glimpse(), count(), distinct(), filter(), select(), mutate(), summarise(), group_by(), across(), case_when(), if_else(), str_trim(), str_squish(), str_to_upper(), str_replace_all(), parse_double() e funções do ggplot2.
A solução é adequada porque organiza o processamento em etapas claramente identificadas, registra as decisões por meio de comentários e produz uma base limpa acompanhada de estatísticas, variáveis derivadas e representações gráficas. Dessa forma, outro profissional consegue compreender o procedimento realizado, reproduzir a análise e utilizar os resultados como apoio ao acompanhamento do controle tecnológico do concreto.
## 🧠 Considerações finais
A realização deste relatório permitiu compreender, de forma prática, a importância do tratamento e da organização dos dados antes da realização de análises estatísticas aplicadas à Engenharia Civil. A partir da base de dados do controle tecnológico do concreto, foi possível identificar diferentes tipos de inconsistências que poderiam comprometer a interpretação dos resultados caso os dados fossem utilizados diretamente em sua forma original.
Durante o processo de inspeção, foram identificados valores ausentes, erros de digitação, diferenças na padronização das categorias, problemas relacionados à representação dos números e valores com ordem de grandeza inadequada. A identificação desses problemas evidenciou que o tratamento dos dados é uma etapa essencial para garantir maior confiabilidade às análises realizadas.
A criação da base `dados_limpos` possibilitou organizar e padronizar as informações sem alterar a base original. Por meio das ferramentas da família tidyverse, foram realizadas correções, conversões e transformações que tornaram os dados mais adequados para a análise. Além disso, a utilização de estatísticas descritivas e gráficos permitiu explorar o comportamento da resistência à compressão e sua relação com outras variáveis relacionadas ao concreto.
Os resultados obtidos também demonstraram a importância de analisar os dados de maneira conjunta, considerando não apenas valores médios, mas também medidas como mediana, desvio padrão, valores mínimo e máximo e a distribuição dos resultados. As visualizações contribuíram para identificar diferenças entre os tipos de concreto e compreender melhor o comportamento das variáveis analisadas.
Dessa forma, os objetivos propostos para a atividade foram alcançados, uma vez que foi possível inspecionar, diagnosticar, limpar, transformar e explorar uma base de dados de uma situação prática da Engenharia Civil. O uso do R e das ferramentas do tidyverse mostrou-se adequado para estruturar um processo de análise organizado, eficiente e reprodutível.
Por fim, destaca-se que a qualidade das informações obtidas em uma análise está diretamente relacionada à qualidade dos dados utilizados. No contexto do controle tecnológico do concreto, a adoção de procedimentos padronizados para coleta, registro e armazenamento das informações pode reduzir a ocorrência de erros e contribuir para avaliações mais confiáveis. Assim, o conhecimento das ferramentas de tratamento e análise de dados constitui uma importante competência para o profissional de Engenharia Civil, especialmente no acompanhamento e na tomada de decisões relacionadas à qualidade dos materiais e dos processos construtivos.
## 📖 Referências