---
# Só mude aqui!!!!
author: "Bruno Henrique e Lucas Felipe"
title: "Relatório de Aula Prática 02"
bibliography: referencias.bib
# A partir daqui nao faca alteracoes!!!!!
link-citations: true
csl: associacao-brasileira-de-normas-tecnicas-ipea.csl
subtitle: "<a href='https://bendeivide.github.io/courses/epaec/' target='_blank'>Estatística e Probabilidade</a> </br> <a href='https://bendeivide.github.io' target='_blank'>Prof. Ben Dêivide (DEFIM/CAP/UFSJ)</a>"
include-before-body: header.html
date: now
date-format: "DD/MM/YYYY, HH:mm"
lang: pt-BR
format:
html:
toc: true
number-sections: true
theme: bootstrap
css: styles.css
code-fold: false
code-tools: true
execute:
echo: true
warning: false
message: false
---
## 📌 Introdução
O controle tecnológico do concreto é essencial para avaliar a qualidade dos materiais e acompanhar o desempenho dos elementos executados em uma obra. Para que essas avaliações sejam confiáveis, é necessário que os dados obtidos em ensaios e registros de campo estejam organizados, completos e coerentes com as características analisadas.
Na prática da Engenharia Civil, informações provenientes de diferentes profissionais e fontes podem apresentar falhas de preenchimento, divergências de padronização, valores ausentes e erros de registro. Por isso, o tratamento inicial da base de dados constitui uma etapa indispensável antes da realização de análises estatísticas.
Neste trabalho, será utilizada a linguagem R, com ênfase nos recursos de Base R, para avaliar uma base de dados relacionada ao controle tecnológico do concreto. Serão realizadas etapas de verificação, correção, padronização e análise exploratória, buscando identificar inconsistências e obter informações que contribuam para uma interpretação adequada dos dados e para o suporte à tomada de decisões na Engenharia Civil.
## 🎯 Objetivos
### Objetivo geral
Executar o tratamento, a validação, a limpeza e a análise exploratória de uma base de dados proveniente do controle tecnológico do concreto, visando à identificação de inconsistências, erros de registro, dados discrepantes e possíveis não conformidades. Além disso, realizar a padronização das variáveis e categorias da base, bem como o processamento de medidas estatísticas descritivas, de modo a subsidiar a avaliação do desempenho e da qualidade do concreto e fornecer informações quantitativas para apoiar a análise técnica e a tomada de decisão pelo profissional responsável.
### Objetivos específicos
- Caracterizar a estrutura da base de dados;
- Verificar a integridade e consistência dos dados;
- Identificar valores discrepantes e possíveis erros de digitação;
- Padronizar as variáveis categóricas e qualitativas;
- Avaliar a distribuição dos dados quantitativos;
- Elaborar tabelas de frequência e representações gráficas;
- Analisar estatisticamente os resultados do controle tecnológico;
- Detectar possíveis registros ou resultados que demandem investigação técnica;
- Organizar uma base de dados tratada e padronizada;
- Produzir informações estatísticas que subsidiem a avaliação da qualidade do concreto.
---
## 📚 Fundamentação Teórica
### Conceitos tecnológicos do concreto
A caracterização tecnológica do concreto envolve variáveis relacionadas à sua composição, ao estado fresco e ao desenvolvimento de suas propriedades mecânicas. Na base de dados analisada, são consideradas a classe do concreto, a idade do corpo de prova, a resistência à compressão, o consumo de cimento, a relação água/cimento, o abatimento, a densidade e a absorção de água do agregado. Entre essas variáveis, a classe do concreto, a resistência à compressão, a idade de ensaio, o abatimento e as propriedades físicas de massa específica e absorção apresentam fundamentação normativa direta nos documentos analisados.
A classificação estrutural e a resistência à compressão constituem propriedades fundamentais para a avaliação do desempenho do concreto. Conforme @nbr8953, o concreto é classificado em função de sua massa específica, resistência e consistência, devendo apresentar resistência característica à compressão ($f_{ck}$) determinada em corpos de prova moldados e rompidos segundo normas específicas. A determinação desta resistência é regulamentada pela ABNT NBR 5739, sendo realizada por meio do ensaio de compressão em corpos de prova cilíndricos [@nbr5739]. A resistência é calculada dividindo-se a força máxima alcançada pela área da seção transversal do corpo de prova, com o resultado expresso em megapascals (MPa). A idade também constitui uma variável essencial, devendo o ensaio respeitar tolerâncias estritas; para o rompimento aos 28 dias, a norma estabelece uma tolerância máxima de 24 horas.
No estado fresco, o abatimento é utilizado como indicador da consistência do concreto. Segundo @nbr16889 o método de ensaio por meio do molde tronco-cônico é aplicável a concretos plásticos e coesos. O resultado do abatimento deve ser medido pela diferença entre a altura do molde e a altura do eixo do corpo de prova desmoldado, sendo expresso em milímetros e arredondado aos 5 mm mais próximos. O abatimento também dita o método de adensamento na moldagem: a ABNT NBR 5738 determina que concretos com abatimento entre 10 mm e 50 mm requerem adensamento mecânico, enquanto abatimentos acima de 160 mm exigem adensamento manual [@nbr5738].
A idade, bem como as condições de moldagem e cura, devem ser consideradas conjuntamente com a resistência obtida. Os corpos de prova devem ser armazenados sob cura inicial protegidos de intempéries e perda de água nas primeiras 24 horas. Posteriormente, para fins de comprovação da qualidade, devem ser mantidos em câmara úmida ou imersos em água saturada de hidróxido de cálcio à temperatura de 23 ± 2 °C até o momento do ensaio [@nbr5738].
Por fim, as propriedades físicas do material no estado endurecido são avaliadas segundo @nbr9778. Esta norma prescreve a determinação da massa específica (densidade) e da absorção de água por imersão. A absorção é quantificada pela relação percentual do incremento de massa do corpo sólido, devido à penetração de água em seus poros permeáveis (após saturação e fervura por 5 horas), em relação à sua massa seca em estufa a 105 ± 5 °C.
### Estatística descritiva aplicada à Engenharia
A Análise Exploratória de Dados constitui uma etapa inicial fundamental para compreender o comportamento das variáveis, organizar e resumir as informações e identificar padrões, tendências e possíveis anomalias. Nesse processo, os dados podem ser classificados em qualitativos, relacionados a atributos ou categorias, e quantitativos, representados por valores numéricos, que podem ser discretos ou contínuos. Essa classificação é essencial para a escolha adequada dos métodos estatísticos e para garantir o correto tratamento computacional das informações.
A correta identificação desses tipos é fundamental, pois para cada tipo de variável existem técnicas estatísticas e computacionais apropriadas para resumir as informações. Em softwares de análise, erros de digitação (como a inserção de letras em variáveis de mensuração) forçam a conversão incorreta de variáveis quantitativas para qualitativas, inviabilizando as operações aritméticas necessárias.
Outro pilar da fundamentação para a limpeza de dados é o comportamento das medidas de posição central, especialmente a média e a mediana. A média aritmética é a medida mais utilizada para resumir um conjunto de observações numéricas. Contudo, ela possui uma vulnerabilidade crítica: a média não é uma medida resistente, pois é afetada de forma exagerada por valores extremos. Esses valores extremos, que se apresentam bastante afastados do corpo principal dos dados, são denominados pontos exteriores, valores discrepantes ou outliers. Do ponto de vista estatístico e prático, um outlier pode ser o produto de um erro de observação, de falhas no ensaio ou de um erro de digitação.
Por outro lado, a mediana é considerada uma medida resistente, pois não é muito afetada por valores atípicos ou discrepantes. Sendo assim, o tratamento prévio da base de dados (limpeza) torna-se uma exigência teórica rigorosa: se os dados brutos contiverem erros de digitação ou outliers irreais (como variáveis fora da escala física possível), a aplicação direta da média e do desvio padrão gerará resultados distorcidos, uma vez que essas medidas não possuem resistência matemática a anomalias [@morettin2017estatistica].
### Linguagem R e suas estruturas computacionais
O R é um software voltado para a computação estatística e manipulação de dados. A arquitetura da linguagem fundamenta-se em princípios centrais, destacando-se que "tudo o que existe no R é um objeto" e "tudo o que acontece no R é uma chamada de função". Na análise exploratória e tratamento de dados, compreender o comportamento desses objetos e das funções que os manipulam é essencial.
#### Importação e Estruturas de Dados
Segundo @Rbasico2022:
- Quadros de Dados (Data Frames): A importação de arquivos de texto e tabelas (utilizando funções derivadas de `read.table()`, como `read.csv()` e `read.csv2()`) resulta na criação de um objeto da classe `data.frame`. Essa estrutura de dados é fundamentalmente uma lista, com a restrição de que todos os vetores (colunas) inseridos nela devem possuir exatamente o mesmo comprimento.
- Valores Ausentes (NA): Durante a importação ou coerção de dados, eventuais campos vazios ou formatos incompatíveis podem gerar ausência de informação. No R, quando um elemento não está disponível, ele é representado pela palavra reservada e constante lógica NA (Not Available). Esta constante pode ser coagida para qualquer modo de vetor (numérico, caractere, etc.) sem alterar o tipo original do objeto.
#### Estruturas de controle de fluxo
As estruturas de controle permitem que o código tome decisões e execute processos repetitivos. No tratamento de dados do controle tecnológico, elas assumem papel central na padronização e correção de anomalias.
- `if()` e `else`: Constituem a estrutura condicional básica da linguagem, avaliando uma condição lógica para direcionar o fluxo de execução. Contudo, a função `if()` não é nativamente vetorizada e exige que o teste lógico possua comprimento igual a 1 (um escalar); caso contrário, a linguagem retornará um erro.
- ifelse(): Para contornar a limitação da função `if()` em matrizes e vetores longos, o R disponibiliza o `ifelse()`, que é uma função puramente vetorizada. Ela opera elemento a elemento em um vetor sem a necessidade explícita de criação de um loop iterativo, o que a torna a escolha ideal e eficiente para a limpeza condicional de dados.
- for(): Consiste em uma estrutura de repetição na qual um bloco de declarações (expressões) se repete sob o controle de uma sequência ou contador. Embora seja uma construção lógica poderosa e clássica, os loops tradicionais no ambiente R podem apresentar gasto computacional elevado em grandes bases de dados, sobretudo devido a características inerentes à linguagem interpretada e a processos de cópias de objetos na memória.
#### A Família de Funções apply
Como alternativa eficiente aos loops convencionais, o pacote base do R implementa a família de funções `apply`, cujo objetivo é manipular vetores, matrizes e listas de maneira repetitiva, otimizada e alinhada ao estilo de programação funcional da linguagem [@Rbasico2022].
- `apply()`: Esta função aplica uma operação matemática ou lógica nas margens de um objeto bidimensional ou multidimensional. O argumento `MARGIN` determina a direção do cálculo: recebe `1` para aplicar a função ao longo das linhas e `2` para aplicar ao longo das colunas.
- `lapply()`: Aplica uma determinada função a todos os elementos de uma lista ou de um data frame. O comportamento semântico desta função dita que ela deve retornar obrigatoriamente outra lista como resultado final.
- `sapply()`: Atua como um encapsulamento (wrapper) da função `lapply()`, realizando as mesmas execuções matemáticas. A diferença crucial é que o `sapply()` possui o argumento padrão de simplificação, que converte a lista resultante em uma estrutura de dados visualmente mais legível, como um vetor atômico ou uma matriz.
## ⚙️ Metodologia
O desenvolvimento do trabalho foi realizado por meio do processamento e da análise de uma base de dados referente ao controle tecnológico do concreto, composta por 100 observações e 10 variáveis. As atividades foram executadas utilizando a linguagem R, priorizando recursos de Base R abordados na disciplina.
### Etapas Metodológicas
- Inicialmente, foi realizada a inspeção da base de dados, contemplando sua importação, identificação do número de observações e variáveis, análise da estrutura, tipos das variáveis e obtenção de um resumo geral das informações. Também foram verificadas a existência e a localização de valores ausentes, permitindo uma avaliação preliminar da qualidade dos dados.
- Na segunda etapa, foi realizada a investigação de inconsistências, buscando identificar valores incompatíveis com o contexto do controle tecnológico do concreto, possíveis erros de digitação, problemas de ordem de grandeza e diferenças na forma de registro das categorias. Foram analisadas variáveis relacionadas à idade dos corpos de prova, resistência à compressão, abatimento, densidade, relação água/cimento e absorção, além da padronização das variáveis qualitativas obra e tipo_concreto.
- Posteriormente, foi criada uma cópia da base original, denominada dados_limpos, utilizada para o processo de tratamento e organização dos dados, preservando-se a base inicial para fins de comparação. Nessa etapa foram corrigidas inconsistências identificadas, padronizadas categorias, ajustados os tipos das variáveis e avaliadas as estratégias mais adequadas para o tratamento dos valores ausentes. Ao final da limpeza, a estrutura e o resumo da nova base foram novamente analisados para verificar as alterações realizadas.
- Com os dados tratados, iniciou-se a análise exploratória, sendo calculadas resistências médias gerais e agrupadas por bloco da obra, tipo de concreto e idade dos corpos de prova. Também foram realizadas comparações entre os diferentes blocos e classes de concreto, além da aplicação da função aggregate() para obtenção de estatísticas das principais propriedades do concreto.
- Em seguida, foram criadas variáveis derivadas, como a resistência relativa, a classificação dos corpos de prova e a indicação de desempenho acima ou abaixo da média de sua respectiva classe. Essas variáveis permitiram ampliar a interpretação dos resultados e estabelecer critérios de comparação entre os registros.
- Também foram empregadas as funções split(), lapply(), sapply() e apply() para explorar diferentes formas de agrupamento, processamento e sumarização dos dados. Foram comparados os resultados obtidos por essas abordagens, considerando aspectos como simplicidade, legibilidade e eficiência do código.
- Na etapa seguinte, foram utilizadas estruturas de programação for e if para percorrer individualmente as observações e identificar corpos de prova com resistência superior à média de sua classe. Posteriormente, o mesmo procedimento foi realizado por meio de uma abordagem vetorizada, possibilitando a comparação entre as duas estratégias de programação.
- Depois, foi realizada uma análise aplicada à prática profissional, investigando afirmações relacionadas ao desempenho dos blocos, à influência do consumo de cimento e à relação água/cimento sobre a resistência do concreto, além da evolução da resistência em função da idade dos corpos de prova. A partir dessas análises, foram selecionadas informações estatísticas consideradas relevantes para subsidiar a elaboração de um relatório destinado ao engenheiro responsável.
- Como etapa final, foi elaborado um script organizado em R, reunindo os procedimentos de inspeção, diagnóstico, limpeza, criação de variáveis e análise estatística. A organização do código buscou garantir clareza, rastreabilidade e facilidade de interpretação, de modo que os procedimentos pudessem ser reproduzidos e compreendidos por outro profissional da área. Dessa forma, a metodologia adotada permitiu transformar uma base de dados inicialmente sujeita a inconsistências em um conjunto de informações estruturadas e adequado à análise descritiva e ao apoio à tomada de decisões na Engenharia Civil.
## 🔍 Resultados e Discussão
### Inspeção inicial da base de dados
Inicialmente, foi realizada a importação e inspeção da base de dados, buscando verificar sua estrutura, características e possíveis inconsistências. Essa etapa permitiu identificar o número de observações e variáveis, os tipos de dados reconhecidos pelo R e possíveis problemas que poderiam comprometer as análises posteriores. Como a base contém registros de controle tecnológico do concreto, essa verificação inicial é fundamental para garantir a qualidade e adequação dos dados antes da aplicação dos métodos estatísticos.
```{r}
#| echo: false
# Importação da base de dados, criação do objeto dados e atribuição da base de dados ao objeto criado.
dados <- read.csv2(
"base_processamento_dados_engenharia_civil.csv",
stringsAsFactors = FALSE,
check.names = FALSE
)
c(
Observações = nrow(dados),
Variáveis = ncol(dados) # Número de observações e número de variáveis
)
str(dados) # Descrição da estrutura da base
```
A base possui 100 observações e 10 variáveis, relacionadas a corpos de prova de concreto. Com base na descrição da estrutura da base de dados, percebe-se que o R interpretou as seguintes variáveis como qualitativas (character):
- `id_corpo_prova` (identificação do corpo de prova)
- `obra` (Bloco da obra onde ocorreu a concretagem)
- `tipo_concreto` (Classe do Concreto)
- `resistencia_mpa`(Resistência à compressão em MPa)
- `cimento_kg_m3`(Consumo de cimento em kg/m³)
- `relacao_a_c` (relação água/cimento)
- `abatimento_mm` (abatimento do concreto, em mm)
- `densidade_kg_m3`(densidade aparente do concreto, em kg/m³)
- `absorção_agregado_pct` (Absorção de água do agregado, em %).
A única variável reconhecida como quantitativa foi: `idade_dias` (Idade do corpo de prova no momento do ensaio).
Esse equívoco ocorre devido à forma como os dados foram registrados e/ou alterados. Por isso, a análise da estrutura ajuda a verificar se cada variável foi interpretada corretamente.
Como visto, apenas a variável `idade_dias` foi reconhecida pelo R como numérica (int), enquanto as demais aparecem como character (chr). Embora algumas sejam realmente qualitativas, como obra, corpo de prova e tipo de concreto, todas as demais variáveis são quantitativas, mas foram armazenadas como texto devido a possíveis problemas de formatação, como vírgulas decimais, valores vazios ou caracteres inadequados.
**Resumo dos dados:**
```{r}
#| echo: false
summary(dados) # Resumo dos dados
```
O resumo das variáveis apresenta informações sobre as observações da base de dados. Para variáveis do tipo `character`, o termo `Length` indica a quantidade de registros; `N.unique`, o número de valores distintos; `N.blank`, a quantidade de células vazias; e `Min.nchar` e `Max.nchar`, respectivamente, o menor e o maior número de caracteres encontrados nos valores.
Para a variável idade do corpo de prova (CP), os termos apresentados acima representam medidas estatísticas de posição e dispersão dos dados: `Min.` (mínimo) indica o menor valor observado; `1st Qu.` (primeiro quartil) corresponde ao valor abaixo do qual estão aproximadamente 25% das observações; `Median` (mediana) representa o valor central, separando os dados em duas partes iguais; `Mean` (média); `3rd Qu.` (terceiro quartil) indica o valor abaixo do qual estão aproximadamente 75% das observações; e `Max.` (máximo) representa o maior valor observado. Esses valores permitem compreender como as idades dos corpos de prova estão distribuídas na base.
Do ponto de vista da engenharia civil, destaca-se que variáveis quantitativas (resistência, consumo de cimento, relação a/c, abatimento, densidade e absorção) estão sendo reconhecidas como texto (character), quando deveriam ser numéricas. Essa inconsistência deve ser corrigida antes da análise estatística.
Também foram identificados valores vazios em algumas dessas variáveis, que devem ser tratados como possíveis dados ausentes (`N.blank`). A variável idade já é numérica, apresentando mediana e média de 28 dias, valor coerente com a referência usual para avaliação do concreto. O máximo de 280 dias, contudo, deve ser conferido para verificar sua consistência, uma vez que as normas de controle tecnológico do concreto não mencionam esse valor.
Já as variáveis `id_corpo_prova`, `obra` e `tipo_concreto` devem permanecer como variáveis textuais/categóricas, pois representam identificação e categorias, e não grandezas quantitativas.
**Valores Ausentes**
Para garantir que o R identifique corretamente as células vazias da planilha original como valores ausentes (NA), a importação foi ajustada utilizando-se o argumento `na.strings = ""`. Sem esse parâmetro, devido aos erros de digitação prévios, o software interpretaria os campos sem preenchimento estritamente como textos em branco (""), mascarando a real quantidade de dados faltantes durante o diagnóstico.
```{r}
#| echo: true
dados <- read.csv2(
  "base_processamento_dados_engenharia_civil.csv",
  stringsAsFactors = FALSE,
  check.names = FALSE,
  na.strings = ""
)
```
Assim, ao contabilizar os valores ausentes (NA), tem-se como resultados:
- total de valores ausentes:
```{r}
#| echo: false
# Contar o total de valores ausentes na base
sum(is.na(dados))
```
- variáveis com valores ausentes:
```{r}
#| echo: false
# Verificar os valores ausentes por variável
sapply(dados, function(x) sum(is.na(x)))
```
- observações com valores ausentes:
```{r}
#| echo: false
# Isola todas as linhas que possuem pelo menos um valor ausente
linhas_ausentes <- dados[!complete.cases(dados), ]
# Imprime as observações completas na tela
linhas_ausentes
```
Foram identificados, portanto, `r sum(is.na(dados))` valores ausentes em toda a base de dados. Esses dados faltantes estão distribuídos pontualmente nas variáveis `r paste(names(which(sapply(dados, function(x) sum(is.na(x))) > 0)), collapse = ", ")`. As observações que apresentam esses furos correspondem aos corpos de prova `r paste(dados$id_corpo_prova[!complete.cases(dados)], collapse = ", ")`.
### Diagnóstico e identificação de inconsistências nos dados
Para investigar possíveis problemas de qualidade dos dados, foram analisadas as variáveis quantitativas relacionadas às características do concreto, buscando identificar valores que apresentassem comportamento incompatível com o contexto da Engenharia Civil. A análise também buscou identificar valores com características que pudessem indicar erros de digitação ou inconsistências no preenchimento da base. O código desenvolvido permitiu localizar as observações potencialmente problemáticas e apresentar seus registros completos.
```{r}
#| echo: false
# Localizando observações problemáticas (uso de vírgula, erros de digitação) usando for
# Criando Vetor com o nome de todas as colunas que deveriam ser puramente numéricas
colunas_quantitativas <- c(
"idade_dias", "resistencia_mpa", "cimento_kg_m3", "relacao_a_c",
"abatimento_mm", "densidade_kg_m3", "absorção_agregado_pct"
)
cat("Verificando problemas de coerção nas variáveis quantitativas:\n")
# Inicia o loop para percorrer cada uma das colunas listadas acima
for (coluna in colunas_quantitativas) {
# Tenta forçar a conversão para numérico.
# O suppressWarnings esconde o aviso "NAs introduzidos por coerção" da tela
vetor_numerico <- suppressWarnings(as.numeric(dados[[coluna]]))
# Identifica os erros: virou NA na conversão matemática, mas NÃO era um NA original e NÃO era uma célula em branco
erros <- is.na(vetor_numerico) & !is.na(dados[[coluna]]) & dados[[coluna]] != ""
# Se o R encontrou algum erro (any = verdadeiro), ele imprime a variável e o erro
if (any(erros)) {
cat("\n-> Problema(s) detectado(s) na variável '", coluna, "':\n", sep="")
print(dados[[coluna]][erros])
}
}
if ("id_corpo_prova" %in% names(dados)) {
erros_digitacao <- subset(
dados,
trimws(id_corpo_prova) %in% c("CP-008", "CP-019", "CP-045", "CP-064")
)
cat("Os registros identificados como possíveis erros de digitação são apresentados a seguir:\n\n")
print(erros_digitacao)}
```
Os resultados apresentados permitem identificar algumas ocorrências que merecem verificação. Destacam-se os valores 38,7 MPa e 30,4 MPa na variável resistência, que utilizam vírgula como separador decimal, indicando uma inconsistência no formato de armazenamento dos dados. Na variável relação a/c, o valor 0,55 apresenta a mesma característica. Embora esses valores sejam plausíveis do ponto de vista da Engenharia Civil, o uso da vírgula pode impedir o correto reconhecimento dessas informações como valores numéricos pelo R.
O caso mais evidente de possível erro de digitação ocorre na variável consumo de cimento, na observação 64 (CP-064), que apresenta o valor 390o kg/m³. Esse valor é muito elevado para representar o consumo de cimento do concreto e, portanto, pode indicar um erro de preenchimento, relacionado à inserção da letra O, conforme visualizado acima. A observação completa foi apresentada para permitir sua conferência com a fonte original.
Assim, a análise não significa que todos os valores destacados sejam necessariamente erros. Eles são potencialmente problemáticos e devem ser verificados antes da realização das análises estatísticas.
**Verificação de valores incompatíveis com o controle tecnológico do concreto**
Nesta etapa, foram investigadas possíveis inconsistências de ordem de grandeza nas variáveis relacionadas ao controle tecnológico do concreto. Para isso, foram estabelecidos limites de verificação coerentes com as características das variáveis, permitindo localizar automaticamente observações que apresentam valores potencialmente incompatíveis com a realidade da Engenharia Civil. Os registros identificados foram posteriormente analisados individualmente, distinguindo-se possíveis erros de digitação de valores que, embora extremos, possam representar situações reais.
```{r}
#| echo: false
# Valores incompatíveis com a Engenharia Civil
# Para usar os operadores (> e <): criar vetores temporários convertendo as vírgulas para pontos.
abatimento_num <- suppressWarnings(as.numeric(gsub(",", ".", dados$abatimento_mm)))
densidade_num <- suppressWarnings(as.numeric(gsub(",", ".", dados$densidade_kg_m3)))
absorcao_num <- suppressWarnings(as.numeric(gsub(",", ".", dados$absorção_agregado_pct)))
# Localizando as observações usando limites lógicos da Engenharia
anomalias_fisicas <- subset(
dados,
idade_dias > 100 | # Idades atípicas (ex: 280)
abatimento_num > 300 | # O cone de Slump tem apenas 300 mm de altura
densidade_num < 2000 | # Concreto gira em torno de 2400 kg/m³
absorcao_num > 10 # Absorção acima de 10% é raríssima para agregados comuns
)
cat("Observações com anomalias de ordem de grandeza:\n")
anomalias_fisicas
```
Abatimento (1250 mm): O cone metálico utilizado no ensaio de Slump Test (NBR 16889) possui exatos 300 mm de altura. É fisicamente impossível o concreto abater 1250 mm. Fica evidente o erro de um "zero" a mais na digitação (o correto seria 125 mm).
Densidade (238 kg/m³): O concreto armado convencional pesa em torno de 2.400 kg/m³. Uma densidade de 238 kg/m³ tornaria o bloco mais leve que a madeira. Provavelmente faltou um zero ao final (2380 kg/m³).
Idade (280 dias): Embora o concreto continue ganhando resistência ao longo dos anos, o controle tecnológico padrão ocorre aos 7, 14 e 28 dias. Um ensaio aos 280 dias é muito improvável em rotinas de obra; trata-se de um zero digitado a mais no lugar de 28 dias.
Absorção (18,4%): Agregados convencionais possuem absorção na casa de 1% a 3%. Um valor de 18,4% sugere uma casa decimal deslocada (o real deveria ser 1,84%).
**Padronização das variáveis: Obra e Tipo de concreto**
Nesta etapa, será realizada a verificação da padronização das variáveis categóricas da base de dados, considerando obra e tipo_concreto. Essa análise é importante porque categorias que representam a mesma informação, mas estão registradas com grafias diferentes, podem ser interpretadas pelo R como categorias distintas, comprometendo a contagem, a organização e as análises posteriores. Assim, serão identificadas possíveis diferenças de grafia, abreviações ou outras inconsistências e verificado se elas representam, de fato, categorias diferentes ou apenas formas distintas de registrar a mesma informação.
Assim, para as variáveis em análise, foram encontrados os seguintes resultados/categorias cadastradas e respectivas localizações em que aparecem:
```{r}
#| echo: false
# Exibe todas as categorias cadastradas e quantas vezes aparecem
table(dados$obra)
# Localiza a observação exata que possui o espaço em branco indesejado
inconsistencia_obra <- subset(dados, obra == "Bloco B ")
inconsistencia_obra
# Exibe todas as categorias cadastradas
table(dados$tipo_concreto)
# Localiza a observação exata que foi digitada com 'c' minúsculo
inconsistencia_concreto <- subset(dados, tipo_concreto == "c30")
inconsistencia_concreto
```
Os resultados da verificação mostram uma inconsistência na padronização da variável obra. Foram identificadas as categorias “Bloco A”, “Bloco B”, “Bloco B ”, “Bloco C” e “Bloco D”. Observa-se que “Bloco B” aparece registrada de duas formas diferentes, sendo uma delas de digitação de um espaço extra, embora represente a mesma obra. Dessa forma, essas categorias devem ser padronizadas para uma única forma de escrita antes das análises posteriores.
Para a variável tipo_concreto, foram encontradas as categorias C25, C30, C30, C35 e C40. Assim como em obra, observa-se uma duplicidade na categoria C30, indicando que ela foi registrada de maneiras distintas, apesar de representar o mesmo tipo de concreto. Portanto, é necessário corrigir essa inconsistência para que o R reconheça todas as observações de C30 como pertencentes a uma única categoria.
### Tratamento e preparação da base de dados
Nesta etapa, serão realizados os procedimentos necessários para corrigir, padronizar e preparar os dados para as análises estatísticas. Será preservada uma cópia da base original, permitindo que as alterações sejam feitas de forma segura. Em seguida, serão corrigidas as inconsistências nas variáveis qualitativas, convertidas as variáveis quantitativas para os tipos adequados e tratados os valores ausentes.
```{r}
# Criando uma cópia da base de dados original
dados_limpos <- dados
```
É recomendável preservar a base original porque ela representa os dados como foram inicialmente obtidos, funcionando como uma referência para comparação e conferência. Dessa forma, os procedimentos de limpeza e correção podem ser realizados em dados_limpos sem alterar permanentemente os dados originais. Isso também permite recuperar informações caso alguma correção seja feita de maneira inadequada, além de garantir maior rastreabilidade e segurança durante o tratamento dos dados.
Conforme apresentado no item 5.2, torna-se necessário corrigir e padronizar as inconsistências identificadas nas variáveis qualitativas `obra` e `tipo_concreto`, bem como realizar a conversão das variáveis que, por sua natureza, deveriam ser classificadas como quantitativas. Essas adequações são fundamentais para garantir a consistência e a correta utilização da base nas análises estatísticas subsequentes.
```{r}
#| echo: false
# Corrijindo os problemas encontrados nas variáveis qualitativas, de modo que suas categorias fiquem padronizadas.
dados_limpos$obra <- trimws(toupper(dados_limpos$obra))
dados_limpos$tipo_concreto <- trimws(toupper(dados_limpos$tipo_concreto))
```
```{r}
#| echo: false
# Conversão das variáveis que deveriam ser quantitativas.
colunas_quantitativas <- c(
"resistencia_mpa", "cimento_kg_m3", "relacao_a_c",
"abatimento_mm", "densidade_kg_m3", "absorção_agregado_pct"
)
# Substitui as vírgulas por pontos em todas as colunas
for (coluna in colunas_quantitativas) {
dados_limpos[[coluna]] <- gsub(",", ".", dados_limpos[[coluna]])
}
# Tratamentos direcionados baseados em julgamento técnico da Engenharia:
# Na resistência, o erro foi "3O.4", então trocamos 'O' por '0'
dados_limpos$resistencia_mpa <- gsub("O|o", "0", dados_limpos$resistencia_mpa)
# No cimento, o erro foi "390O", então apenas apagamos a letra 'O' (substitui por vazio "")
dados_limpos$cimento_kg_m3 <- gsub("O|o", "", dados_limpos$cimento_kg_m3)
# 3. Converte definitivamente todas as colunas limpas para numéricas
for (coluna in colunas_quantitativas) {
dados_limpos[[coluna]] <- as.numeric(dados_limpos[[coluna]])
}
cat("Estrutura das variáveis após a conversão com julgamento técnico:\n")
str(dados_limpos[colunas_quantitativas])
```
Ao realizar a conversão das variáveis textuais para quantitativas, notou-se que a aplicação de uma regra automatizada e global de substituição (como trocar todas as letras 'O' por zeros) geraria anomalias físicas. Na variável `cimento_kg_m3`, o registro "390O" se tornaria 3.900 kg/m³, um valor fisicamente impossível que ultrapassa a massa específica do próprio concreto (aprox. 2.400 kg/m³). Logo, o erro consistia em um caractere adicional, exigindo a sua simples exclusão. Já na variável `resistencia_mpa` (registro "3O,4"), a letra substituía o zero de fato, devendo ser trocada. Essa etapa demonstra que a limpeza de dados na Engenharia Civil não é um processo puramente computacional, exigindo análise crítica e julgamento técnico sobre as ordens de grandeza dos fenômenos estudados antes da coerção final com a função `as.numeric()`.
Para facilitar a identificação dos valores ausentes na base de dados, desenvolveu-se uma função personalizada em R para filtrar e retornar exclusivamente as observações que apresentam pelo menos uma variável com o status NA. A aplicação desta função na base de dados recém-convertida permitiu visualizar os registros completos afetados, fornecendo o embasamento necessário para decidir o tratamento estatístico adequado para esses casos específicos.
```{r}
#| echo: false
# Identificando os valores ausentes
# Criando uma função personalizada para localizar linhas com NA
mostrar_linhas_na <- function(base_de_dados) {
# !complete.cases retorna TRUE apenas para linhas que têm algum NA
linhas_com_problema <- base_de_dados[!complete.cases(base_de_dados), ]
# Retorna a tabela apenas com as observações afetadas
return(linhas_com_problema)
}
# Aplicando a função na nossa base já limpa e convertida
cat("Observações que contêm valores ausentes (NA) após a conversão:\n")
mostrar_linhas_na(dados_limpos)
```
Para a situação específica do item 5.2, ou seja, valores incompativeis com as normas e/ou com a rotina da construção civil (abatimento com valor de 1250 mm, densidade 238 kg/m³, idade de 280 dias e absorção de 18,4%), a decisão técnica mais correta (e a que renderá a melhor avaliação estatística) é alterar os valores, corrigindo o erro de digitação com base no seu julgamento técnico, em vez de substituí-los por NA.
Na prática da Engenharia, se o erro fosse completamente aleatório e impossível de deduzir, a substituição por NA seria o caminho seguro. No entanto, os problemas localizados apresentam um padrão (um zero a mais, um zero a menos ou a vírgula deslocada uma casa).
Corrigindo essas anomalias:
```{r}
#| echo: false
# Corrigindo anomalias físicas evidentes (erros de digitação/casas decimais)
# A função ifelse(teste, valor_se_verdadeiro, valor_se_falso) aplica a correção pontualmente
dados_limpos$idade_dias <- ifelse(dados_limpos$idade_dias == 280, 28, dados_limpos$idade_dias)
dados_limpos$abatimento_mm <- ifelse(dados_limpos$abatimento_mm == 1250, 125, dados_limpos$abatimento_mm)
dados_limpos$densidade_kg_m3 <- ifelse(dados_limpos$densidade_kg_m3 == 238, 2380, dados_limpos$densidade_kg_m3)
# Para a absorção, sabemos que o valor 18.4 foi um deslocamento de casa decimal, dividimos por 10
dados_limpos$absorção_agregado_pct <- ifelse(dados_limpos$absorção_agregado_pct > 10, dados_limpos$absorção_agregado_pct / 10, dados_limpos$absorção_agregado_pct)
```
**Tratamento de Valores Ausentes:** foram identificados exatamente 5 valores ausentes, distribuídos pontualmente nas seguintes observações:
* **CP-015:** Ausência de `abatimento_mm`
* **CP-038:** Ausência de `relacao_a_c`
* **CP-077:** Ausência de `densidade_kg_m3`
* **CP-092:** Ausência de `resistencia_mpa`
* **CP-097:** Ausência de `absorção_agregado_pct`
**Discussão e Justificativa dos Procedimentos:** A consulta à fonte original deve ser priorizada, pois permite recuperar os valores faltantes e garantir a integridade da base. Quando isso não for possível, recomenda-se manter os NA, preservando as demais informações válidas da observação e permitindo que o R desconsidere apenas os valores ausentes nos cálculos. A imputação de valores, como substituir um NA pela média, é desaconselhada no controle tecnológico, pois pode mascarar resultados reais. Da mesma forma, a exclusão de toda a observação é desnecessária quando apenas algumas variáveis apresentam dados faltantes. Assim, optou-se por manter os NA, preservando as 100 observações e garantindo que as análises posteriores utilizem apenas valores efetivamente registrados.
**Verificação da Estrutura após o Tratamento**
```{r}
#| echo: false
# Verificando a estrutura dos dados após a limpeza
str(dados_limpos)
summary(dados_limpos)
# O que mudou em relação à base original?
```
A comparação entre a estrutura dos dados originais e a base limpa revela duas transformações principais:
- Conversão de Tipos de Dados: As variáveis que representam as propriedades físicas do concreto, inicialmente lidas pelo R como texto (chr), foram devidamente convertidas para o formato numérico (num). Com isso, a função summary() passou a calcular e exibir estatísticas descritivas (como médias, medianas, valores mínimos e máximos) em vez de simples contagens de caracteres.
- Padronização de Categorias: As variáveis de texto obra e tipo_concreto foram padronizadas estruturalmente (com letras maiúsculas e remoção de espaços em branco). Essa limpeza refletiu na redução do número de categorias únicas (N.unique) de 5 para 4 em ambas as colunas, aglutinando os registros que antes estavam separados devido a inconsistências de digitação.
### Análise dos Dados
Após a inspeção e a limpeza da base, inicia-se a etapa de exploração dos dados, com o objetivo de obter informações descritivas sobre o comportamento do concreto. Nesta etapa, serão calculadas as resistências médias à compressão, considerando o conjunto de corpos de prova e diferentes agrupamentos, como bloco da obra, tipo de concreto e idade. Também serão comparadas as obras e as classes de concreto, buscando identificar aquelas que apresentam maiores ou menores valores médios de resistência.
**Resistência Média**
```{r}
#| echo: false
# Resistência média geral (salvando em um objeto isolado)
media_geral <- round(mean(dados_limpos$resistencia_mpa, na.rm = TRUE), 2)
# Resistência média por bloco da obra
media_bloco <- aggregate(resistencia_mpa ~ obra, data = dados_limpos, mean, na.rm = TRUE)
media_bloco$resistencia_mpa <- round(media_bloco$resistencia_mpa, 2) # Arredondando
# 3. Resistência média por tipo de concreto
media_tipo <- aggregate(resistencia_mpa ~ tipo_concreto, data = dados_limpos, mean, na.rm = TRUE)
media_tipo$resistencia_mpa <- round(media_tipo$resistencia_mpa, 2)
# 4. Resistência média por idade
media_idade <- aggregate(resistencia_mpa ~ idade_dias, data = dados_limpos, mean, na.rm = TRUE)
media_idade$resistencia_mpa <- round(media_idade$resistencia_mpa, 2)
```
A resistência média global calculada para o empreendimento foi de `r media_geral` MPa. Já a resistência média por bloco da obra foi observada da seguinte forma:
`r knitr::kable(media_bloco, col.names = c("Bloco da Obra", "Resistência Média (MPa)"))`
Resistência média por tipo de concreto:
`r knitr::kable(media_tipo, col.names = c("Classe do Concreto", "Resistência Média (MPa)"))`
Resistência média por idade do corpo de prova:
`r knitr::kable(media_idade, col.names = c("Idade (dias)", "Resistência Média (MPa)"))`
**Comparação entre obras**
Utilizando os códigos em R apresentados a seguir, foi possível identificar o bloco da obra que apresentou a maior e a menor resistência média:
```{r}
#| echo: true
# Comparação entre obras
# Calcula a resistência média por bloco da obra
medias_bloco <- tapply(
  dados_limpos$resistencia_mpa,
  dados_limpos$obra,
  mean,
  na.rm = TRUE
)
```
```{r}
#| echo: false
# Imprime todas as médias calculadas para conferência
print("Médias de Resistência por Bloco:")
print(medias_bloco)
# Encontra os blocos com maior e menor resistência
maior_bloco <- names(which.max(medias_bloco))
menor_bloco <- names(which.min(medias_bloco))
# Imprime os resultados formatados de forma descritiva
cat("\nO bloco com a MAIOR resistência média foi o", maior_bloco, "\n")
cat("O bloco com a MENOR resistência média foi o", menor_bloco, "\n")
```
**Resistência Média x Tipo de Concreto**
Dados da resistência média calculada para cada tipo de concreto:
```{r}
#| echo: false
# resistência média para cada classe de concreto
medias_concreto <- tapply(dados_limpos$resistencia_mpa,
dados_limpos$tipo_concreto,
mean,
na.rm = TRUE
)
medias_concreto
# Maior resistência média
maior_concreto <- names(which.max(medias_concreto))
# Imprimir o resultado
cat("A classe de concreto que apresentou a MAIOR resistência média foi:", maior_concreto, "\n")
```
**Análise das características do concreto por classe**
Para aprofundar a análise dos dados, utilizou-se a função ´aggregate()` para calcular as médias das principais variáveis quantitativas para cada tipo de concreto. Foram consideradas a resistência à compressão, o consumo de cimento, a relação água/cimento, o abatimento e a densidade. Essa abordagem permite comparar as características das diferentes classes de concreto e identificar possíveis diferenças entre seus valores médios.
```{r}
#| echo: false
# Média das variáveis abaixo (para cada tipo de concreto):
aggregate(
cbind(
resistencia_mpa,
cimento_kg_m3,
relacao_a_c,
abatimento_mm,
densidade_kg_m3
) ~ tipo_concreto,
data = dados_limpos,
FUN = mean,
na.rm = TRUE
)
```
Os resultados obtidos permitem caracterizar o comportamento médio das principais variáveis relacionadas ao concreto e realizar comparações entre os diferentes grupos presentes na base. A análise por obra possibilita verificar quais blocos apresentam maiores ou menores resistências médias, enquanto a análise por tipo de concreto permite comparar as classes C25, C30, C35 e C40. A avaliação segundo a idade dos corpos de prova também possibilita observar a variação da resistência em diferentes períodos de ensaio.
A utilização da função aggregate() amplia essa análise ao apresentar, para cada tipo de concreto, as médias de resistência, consumo de cimento, relação água/cimento, abatimento e densidade. Dessa forma, os resultados podem ser interpretados conjuntamente, permitindo identificar diferenças entre as classes de concreto e fornecendo uma visão mais abrangente das características da base de dados.
### Criando novas variáveis
**Resistência relativa:** representa a razão entre a resistência observada e a resistência de referência associada à classe do concreto.
A resistência de referência é definida extraindo-se a porção numérica da própria nomenclatura da classe do concreto (variável tipo_concreto). Na Engenharia Civil, segundo a ABNT NBR 8953, a sigla 'C' seguida de um número indica exatamente a resistência característica à compressão ($f_{ck}$) em MPa exigida para o projeto. Ao dividir a resistência efetivamente rompida no ensaio pelo $f_{ck}$ de projeto, obtemos um índice adimensional (resistencia_relativa). Valores maiores ou iguais a 1,0 indicam que a amostra atingiu ou superou a meta.
```{r}
#| echo: false
# Criando a variável Resistência Relativa
dados_limpos$resistencia_ref <- as.numeric(gsub("C", "", dados_limpos$tipo_concreto))
dados_limpos$resistencia_relativa <- dados_limpos$resistencia_mpa / dados_limpos$resistencia_ref
```
**Classificação:**
```{r}
#| echo: false
# Classificando os corpos de prova: Aprovado se a resistência for >= a de referência
dados_limpos$classificacao <- ifelse(
dados_limpos$resistencia_mpa >= dados_limpos$resistencia_ref,
"Aprovado",
"Em Análise" # Usamos 'Em Análise' porque a reprovação final exige mais de 1 corpo de prova
)
# Contagem de como ficou a classificação geral
table(dados_limpos$classificacao)
```
O critério adotado para a variável classificação foi a verificação primária de atendimento ao $f_{ck}$ projetado. Corpos de prova cuja resistência medida foi maior ou igual à resistência de referência foram classificados como 'Aprovado'. Aqueles que não atingiram a marca (ou seja, resistencia_relativa < 1,0) foram classificados como 'Em Análise'. Tecnicamente, a NBR 12655 estabelece que a aceitação definitiva de um lote de concreto exige cálculos estatísticos mais complexos envolvendo desvios padrões de múltiplos exemplares. No entanto, para fins de controle imediato e filtragem exploratória, identificar individualmente os corpos de prova que falharam em atingir a resistência nominal é o critério de alerta mais eficiente e direto.
**Variável `acima_media`:** indica se a resistência do corpo de prova está acima ou abaixo da resistência média de seu respectivo tipo de concreto. A variável assume valores `TRUE` ou `FALSE`.
```{r}
# Criando a variável booleana (TRUE/FALSE)
# O na.rm = TRUE é vital aqui porque decidimos manter os NAs na Etapa 3
dados_limpos$acima_media <- with(
  dados_limpos,
  resistencia_mpa > ave(resistencia_mpa, tipo_concreto, FUN = function(x) mean(x, na.rm = TRUE))
)

# Imprimindo as primeiras observações para conferir o resultado booleano
head(dados_limpos[, c("id_corpo_prova", "tipo_concreto", "resistencia_mpa", "acima_media")])
```
A função ave() calcula secretamente a média das resistências para cada tipo_concreto individualmente (C25, C30, etc.). Em seguida, o sinal > testa logicamente se a resistencia_mpa daquela linha é maior que a média calculada para o grupo dela. O resultado gerado automaticamente será TRUE ou FALSE.
### Divisão e aplicação de funções por grupos
Nesta etapa, a base de dados será dividida em grupos de acordo com o tipo de concreto, utilizando a função split(). A partir dessa estrutura, serão determinadas as quantidades de observações de cada classe e calculadas as respectivas resistências médias. Para isso, serão utilizadas as funções lapply() e sapply(), permitindo também comparar a forma como cada uma organiza e retorna os resultados.
Inicialmente, o número de observações existentes em cada tipo de concreto é de:
```{r}
#| echo: false
# Dividindo a base de dados de acordo com a variável tipo_concreto
dados_split <- split(dados_limpos, dados_limpos$tipo_concreto)
# Verificando quantas observações existem em cada grupo
# A função sapply aplica o comando 'nrow' (número de linhas) em cada elemento da lista
sapply(dados_split, nrow)
```
Ao utilizar a função `split()`, a base de dados foi fragmentada em uma lista contendo quatro data frames distintos, um para cada classe de concreto (C25, C30, C35 e C40). Para contabilizar as observações, aplicou-se a função `sapply()` combinada com `nrow`, que percorreu a lista e retornou o número exato de linhas de cada grupo de forma simplificada e em formato de vetor. O resultado revelou a exata distribuição dos corpos de prova entre as classes de resistência cadastradas na obra, conforme visualizado acima.
Cálculo da resistência média de cada tipo de concreto usando a função `lapply()`:
```{r}
#| echo: false
# Calculando a resistência média de cada tipo de concreto usando lapply
medias_lapply <- lapply(dados_split, function(df) {
mean(df$resistencia_mpa, na.rm = TRUE)
})
# Exibindo o resultado
medias_lapply
```
Agora, realizando o mesmo cálculo, com a função `sapply`, tem-se:
```{r}
#| echo: false
# Calculando a resistência média de cada tipo de concreto usando sapply
medias_sapply <- sapply(dados_split, function(df) {
mean(df$resistencia_mpa, na.rm = TRUE)
})
# Exibindo o resultado
medias_sapply
# Comprovando as diferenças de classe/estrutura
class(medias_lapply)
class(medias_sapply)
```
A diferença fundamental entre os dois comandos reside na estrutura de dados que eles retornam como saída. A função lapply() (List Apply) iterou sobre cada data frame dentro da lista dados_split e calculou a média da resistência, devolvendo obrigatoriamente outra lista como resultado final. Já a função sapply() (Simplified Apply) executou exatamente a mesma operação matemática, porém foi capaz de simplificar o resultado final, convertendo a lista de respostas em um vetor numérico nomeado. Na prática de Engenharia de Dados, o resultado de sapply() é visualmente mais legível e muito mais fácil de ser inserido em gráficos ou novas tabelas, pois o formato de vetor dispensa o uso de múltiplos colchetes ([[ ]]) para acessar os valores.
### Aplicação de funções sobre as variáveis quantitativas
Nesta etapa, a função apply() será utilizada para resumir as variáveis quantitativas relacionadas às propriedades do concreto, permitindo calcular a média de cada variável e, posteriormente, obter uma medida resumo para cada observação. Essa abordagem possibilita explorar diferentes formas de aplicação das funções no R e discutir os resultados obtidos, especialmente quanto à interpretação física de uma medida calculada a partir de variáveis que possuem diferentes unidades e significados de engenharia.
```{r}
#| echo: false
# Selecionando apenas as colunas quantitativas das propriedades do concreto
vars_quantitativas <- subset(
dados_limpos,
select = c(resistencia_mpa, cimento_kg_m3, relacao_a_c, abatimento_mm, densidade_kg_m3, absorção_agregado_pct)
)
# Utilizando apply na margem 2 (colunas) para calcular a média de cada variável
medias_propriedades <- apply(vars_quantitativas, 2, mean, na.rm = TRUE)
# Exibindo os resultados
print("Médias das propriedades do concreto:")
print(medias_propriedades)
```
```{r}
#| echo: false
# Utilizando apply na margem 1 (linhas) para calcular a média por observação
dados_limpos$medida_resumo <- apply(vars_quantitativas, 1, mean, na.rm = TRUE)
# Exibindo os primeiros resultados para conferência
head(dados_limpos[, c("id_corpo_prova", "medida_resumo")])
```
A medida resumo calculada por linha, embora seja uma operação matemática perfeitamente executável no R por meio da função apply(), não possui nenhuma interpretação física direta ou validade na Engenharia Civil. Ao calcular a média ao longo da linha, o algoritmo está somando grandezas dimensionais completamente incompatíveis entre si: pressão (MPa), consumo e densidade (kg/m³), comprimento (mm) e porcentagem (%). Na física e na engenharia, não se pode somar ou tirar a média de unidades de medidas diferentes. Portanto, o valor gerado é um mero artefato numérico abstrato, sem utilidade para o controle tecnológico da obra.
### Estruturas for e if
```{r}
#| echo: false
# Abordagem iterativa (for + if)
# Inicializa a variável com FALSE para todas as observações
dados_limpos$acima_media_loop <- FALSE
for (i in 1:nrow(dados_limpos)) {
# Isola a classe do concreto da linha atual
classe_atual <- dados_limpos$tipo_concreto[i]
# Calcula a média apenas dos corpos de prova desta mesma classe
media_classe <- mean(dados_limpos$resistencia_mpa[dados_limpos$tipo_concreto == classe_atual], na.rm = TRUE)
# Aplica a estrutura 'if' para validar a condição sem usar ifelse()
# Verifica se o valor não é NA para evitar erros lógicos
if (!is.na(dados_limpos$resistencia_mpa[i]) & dados_limpos$resistencia_mpa[i] > media_classe) {
dados_limpos$acima_media_loop[i] <- TRUE
}
}
# Extrai os IDs dos corpos de prova identificados
corpos_identificados_loop <- dados_limpos$id_corpo_prova[which(dados_limpos$acima_media_loop)]
# Exibe o resultado
cat("Corpos de prova acima da média (Abordagem com Loop):\n")
print(corpos_identificados_loop)
```
```{r}
#| echo: false
# Abordagem vetorizada
# Usa with() e ave() para comparar o indivíduo com a média do grupo em uma única etapa
dados_limpos$acima_media_vetor <- with(
dados_limpos,
resistencia_mpa > ave(resistencia_mpa, tipo_concreto, FUN = function(x) mean(x, na.rm = TRUE))
)
corpos_identificados_vetor <- dados_limpos$id_corpo_prova[which(dados_limpos$acima_media_vetor)]
# Exibe o resultado
cat("\nCorpos de prova acima da média (Abordagem Vetorizada):\n")
print(corpos_identificados_vetor)
```
Comparação Técnica das Abordagens
A abordagem vetorizada exige uma única linha de comando lógico, eliminando a necessidade de inicializar vetores vazios, criar variáveis temporárias (classe_atual) ou manipular colchetes de indexação ([i]).
O código vetorizado é indiscutivelmente mais rápido e otimizado no R. No laço for construído, o R é forçado a calcular a média do concreto C30 repetidas vezes, recalculando a mesma matemática toda vez que encontra um corpo de prova C30. Na solução vetorizada, a função ave() calcula a média de cada classe apenas uma vez em nível C/C++ nos bastidores e distribui a comparação simultaneamente por todo o vetor, poupando processamento.
### Análise aplicada ao controle tecnológico do concreto
Nesta etapa, os dados serão analisados sob uma perspectiva próxima da prática profissional da Engenharia Civil, buscando transformar os resultados estatísticos em informações úteis para a tomada de decisão.
- Análise da afirmativa: “Os concretos utilizados no Bloco C apresentam desempenho superior aos utilizados nos demais blocos.”
A afirmação acima está incorreta e é diretamente refutada pelas estatísticas descritivas da base. Ao realizar o agrupamento das médias, constata-se que o Bloco C apresentou a menor resistência à compressão de todo o empreendimento (aproximadamente 32,62 MPa). O melhor desempenho médio foi registrado no Bloco B (cerca de 35,68 MPa).
- Análise da afirmativa: “Quanto maior o consumo de cimento, maior tende a ser a resistência do concreto.”
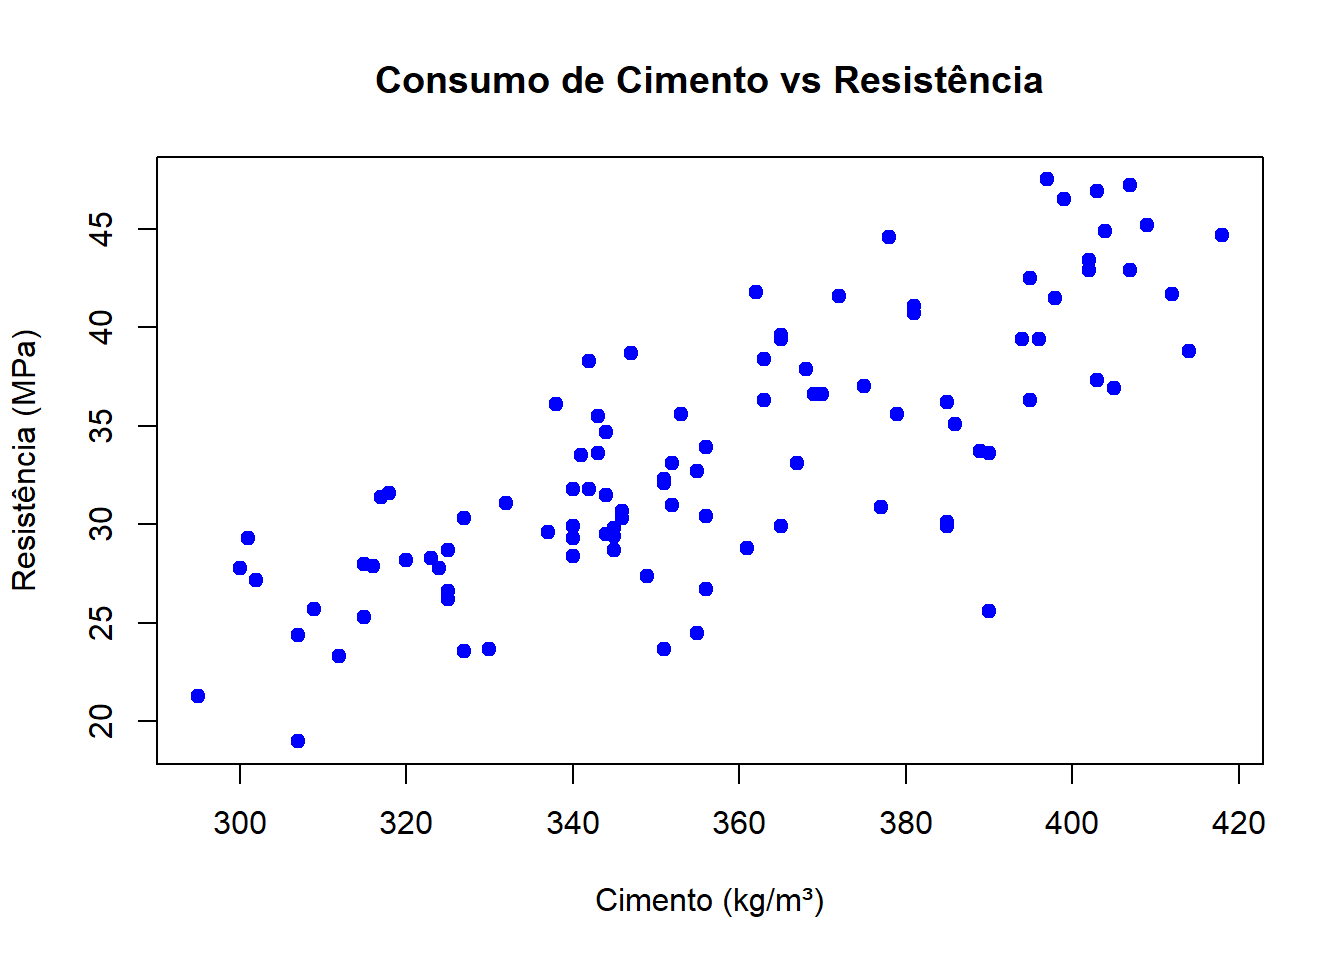
A premissa de que o aumento de cimento eleva a resistência possui fundamento teórico, mas é uma simplificação que pode ocasionar error se avaliada de forma isolada. Um consumo elevado de cimento não garantirá resistência superior se o volume de água na mistura também for excessivo. Para avaliar essa dinâmica corretamente, a variável cimento_kg_m3 deve ser obrigatoriamente analisada em conjunto com a variável relacao_a_c (fator água/cimento) e a idade_dias (momento do ensaio). O uso da correlação linear e do gráfico de dispersão abaixo expõe a dependência entre essas métricas operacionais:
```{r}
#| echo: false
# Gráfico de dispersão para visualização da tendência
plot(dados_limpos$cimento_kg_m3, dados_limpos$resistencia_mpa,
main = "Consumo de Cimento vs Resistência",
xlab = "Cimento (kg/m³)", ylab = "Resistência (MPa)", pch = 19, col = "blue")
```
O gráfico de dispersão apresenta a relação entre o consumo de cimento (kg/m³), no eixo horizontal, e a resistência à compressão (MPa), no eixo vertical. Observa-se uma tendência positiva: de modo geral, os corpos de prova com maiores consumos de cimento apresentam também maiores resistências. Entretanto, existe uma dispersão considerável dos pontos, indicando que o consumo de cimento, isoladamente, não explica completamente a variação da resistência. Essa relação deve ser interpretada com cautela, pois a resistência do concreto depende da interação entre diferentes fatores.
- Análise da Relação Água/Cimento e Resistência à Compressão
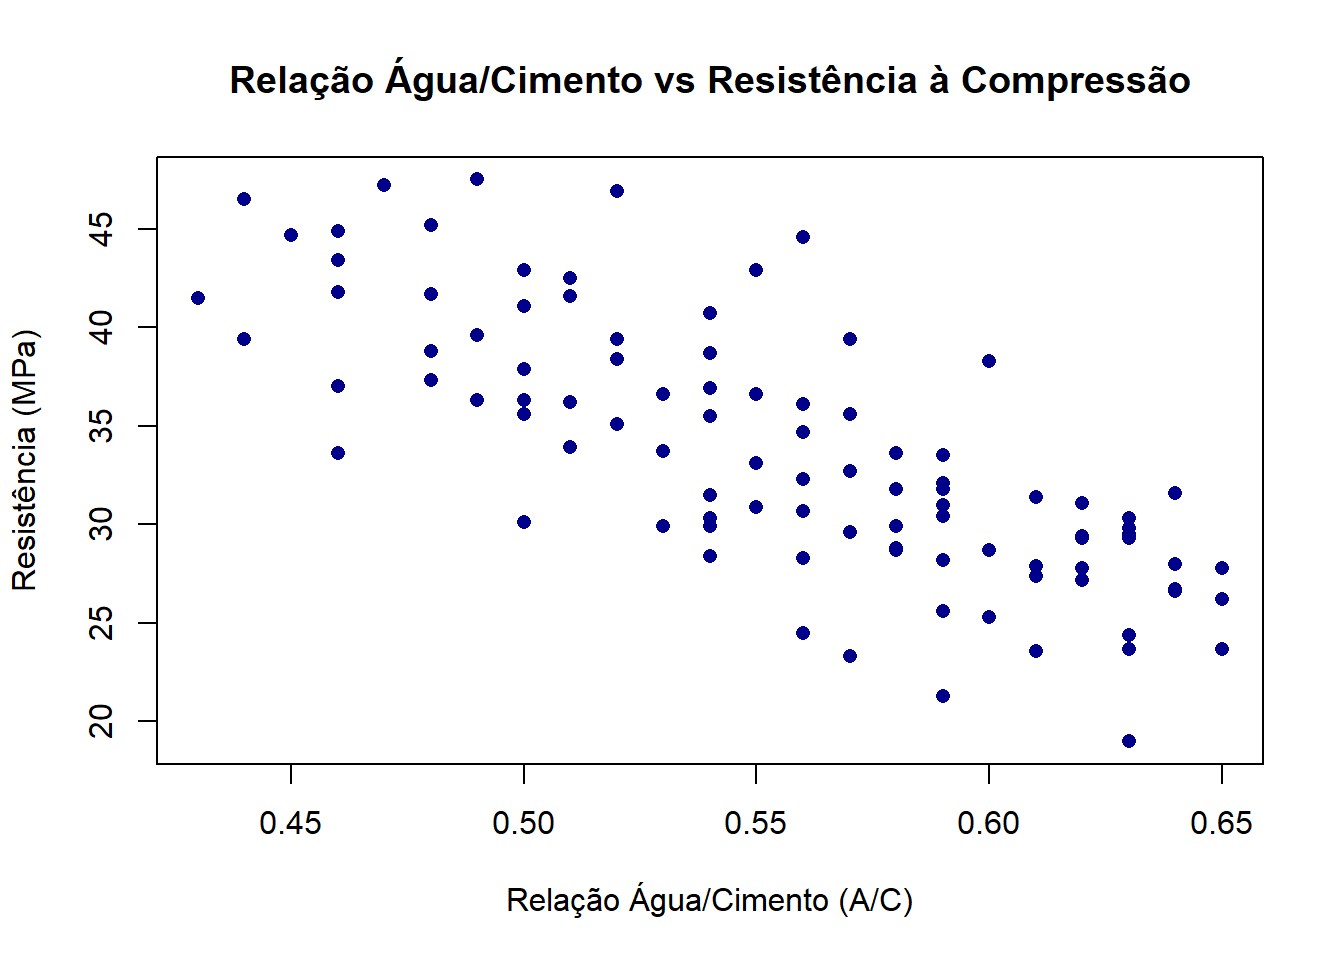
A Lei de Abrams estabelece uma proporcionalidade inversa entre essas duas grandezas: volumes maiores de água geram maior índice de vazios e, consequentemente, menor resistência mecânica. Descritivamente, o gráfico e a correlação (código abaixo) devem apresentar uma forte tendência linear negativa. Caso a base de dados exiba uma correlação nula ou positiva, isso indicará uma falha severa nos registros, sugerindo erros sistemáticos na pesagem dos materiais na central de concreto, problemas no controle do teor de umidade da areia ou falhas no procedimento de adensamento e cura dos corpos de prova em laboratório.
```{r}
#| echo: false
# Gráfico de dispersão entre Relação A/C e Resistência
plot(
x = dados_limpos$relacao_a_c,
y = dados_limpos$resistencia_mpa,
main = "Relação Água/Cimento vs Resistência à Compressão",
xlab = "Relação Água/Cimento (A/C)",
ylab = "Resistência (MPa)",
pch = 16, # Círculos preenchidos
col = "darkblue" # Cor dos pontos
)
```
O gráfico de dispersão evidencia uma clara tendência linear decrescente, confirmando na prática o princípio físico consagrado pela Lei de Abrams na tecnologia do concreto.
Fica evidente que, à medida que a relação água/cimento aumenta no eixo horizontal, a resistência à compressão diminui no eixo vertical. O excesso de água na mistura gera um maior volume de poros capilares após a hidratação e secagem, o que reduz a densidade da matriz cimentícia e compromete diretamente a sua capacidade de suportar cargas.
Em uma análise real de controle tecnológico, qualquer ponto (corpo de prova) que se afaste drasticamente dessa faixa diagonal de tendência negativa constitui uma anomalia grave. Pontos dispersos fora do padrão indicariam a necessidade de investigar imediatamente possíveis erros de pesagem de água na betoneira, falhas no capeamento e rompimento da prensa, ou erros de transcrição de dados no laboratório.
- Evolução da Resistência com a Idade
A resistência à compressão do concreto apresenta um crescimento assintótico com o tempo. A hidratação do cimento Portland ocorre rapidamente nos primeiros dias, gerando um ganho expressivo de resistência até os 7 dias, e segue em ritmo decrescente até estabilizar-se aos 28 dias (idade padrão de controle). Ao extrair as médias, espera-se que a resistência média do grupo de 28 dias seja significativamente superior à dos grupos de 7 ou 14 dias.
```{r}
#| echo: false
aggregate(resistencia_mpa ~ idade_dias, data = dados_limpos, FUN = mean, na.rm = TRUE)
```
Observa-se que a resistência média aumenta de 28,78 MPa aos 7 dias para 34,74 MPa aos 14 dias. Entretanto, ocorre uma pequena redução nas médias aos 28 e 56 dias, atingindo 34,65 MPa e 33,12 MPa, respectivamente. Embora seja esperado, em condições controladas, um aumento da resistência com o avanço da idade, os resultados apresentados não permitem afirmar que essa tendência deva ocorrer necessariamente nas médias da base analisada. Como os grupos de diferentes idades podem apresentar diferentes características de composição e condições de ensaio, a redução observada aos 56 dias deve ser investigada considerando conjuntamente o tipo de concreto, a relação água/cimento, o consumo de cimento e a variabilidade dos resultados.
A análise das características do concreto pode ser direcionada para informações que permitam avaliar seu desempenho e identificar possíveis diferenças entre os grupos analisados. Nesse sentido, destacam-se cinco informações:
- Resistência média à compressão: permite caracterizar o desempenho mecânico geral dos corpos de prova e estabelecer uma referência para as demais comparações.
- Resistência média por bloco da obra: possibilita verificar diferenças de desempenho entre os blocos e identificar aqueles que apresentam resultados relativamente maiores ou menores.
- Resistência média por tipo de concreto: permite comparar as diferentes classes (C25, C30, C35 e C40) e verificar como o desempenho varia conforme o tipo de concreto.
- Resistência média em diferentes idades: possibilita observar a evolução da resistência ao longo do tempo e verificar o comportamento dos corpos de prova nas diferentes idades de ensaio.
- Relação água/cimento e resistência à compressão: permite analisar conjuntamente uma característica da composição do concreto e seu desempenho mecânico, auxiliando na identificação de tendências e de resultados que mereçam investigação.
Em conjunto, essas informações permitem caracterizar o desempenho do concreto, comparar diferentes condições e identificar padrões ou resultados atípicos que possam demandar uma análise mais detalhada.
## 🧠 Considerações finais
A realização desta atividade permitiu compreender, de forma prática, a importância do processamento, da limpeza e da análise estatística de dados no contexto da Engenharia Civil. A base analisada era composta por 100 observações e 10 variáveis relacionadas ao controle tecnológico do concreto, incluindo resistência à compressão, consumo de cimento, relação água/cimento, abatimento, densidade, absorção, idade dos corpos de prova, obra e classe do concreto. Durante a análise inicial, foram identificados alguns problemas na estrutura da base de dados. Algumas variáveis que deveriam ser quantitativas estavam armazenadas como texto, além da presença de valores ausentes, diferenças de formatação e erros de digitação. Também foram encontrados valores que apresentavam características incompatíveis com as propriedades analisadas, sendo necessário avaliar cada situação antes de realizar os cálculos estatísticos.
Para solucionar esses problemas, foi realizada uma etapa de limpeza e organização dos dados, com a padronização das informações e a correção dos erros de digitação identificados. Em alguns casos, foi necessário utilizar o conhecimento técnico para determinar a melhor forma de corrigir os valores, evitando alterações que pudessem gerar resultados fisicamente impossíveis. Os dados ausentes foram mantidos sem preenchimento quando não havia informação suficiente para determinar o valor correto. O uso do R foi importante durante toda a atividade, pois permitiu organizar e verificar a base de dados, realizar as correções necessárias e executar os cálculos estatísticos de maneira mais rápida e organizada. Além disso, o programa possibilitou analisar diferentes grupos de dados e comparar os resultados obtidos, tornando o processo mais eficiente e reprodutível.
Após o tratamento dos dados, foram realizados cálculos estatísticos descritivos, principalmente envolvendo médias de resistência à compressão. A resistência média geral encontrada foi de 33,55 MPa. Na comparação entre os blocos, o Bloco B apresentou a maior resistência média, com 35,70 MPa, enquanto o Bloco C apresentou a menor média, com 32,37 MPa. Também foi possível observar diferenças entre as classes de concreto, sendo as médias de resistência de 27,07 MPa para a classe C25, 32,08 MPa para C30, 37,10 MPa para C35 e 43,33 MPa para C40. As análises também permitiram observar a relação entre diferentes propriedades do concreto. Foi identificada uma tendência de aumento da resistência com o aumento do consumo de cimento, embora com certa dispersão nos resultados. Em relação à quantidade de água, observou-se uma tendência de redução da resistência à medida que aumenta a relação água/cimento, comportamento compatível com os princípios da tecnologia do concreto.
Dessa forma, a atividade demonstrou que a análise estatística é uma ferramenta importante para a Engenharia Civil, mas seus resultados dependem diretamente da qualidade dos dados utilizados. O processamento e a limpeza da base são etapas indispensáveis para garantir resultados confiáveis. O uso do R facilitou a organização dos dados e a realização dos cálculos, enquanto o conhecimento técnico foi fundamental para interpretar e tratar corretamente as inconsistências encontradas. Assim, a combinação entre ferramentas computacionais, cálculos estatísticos e conhecimento de Engenharia Civil permite obter informações mais confiáveis para auxiliar na análise e na tomada de decisões.
### Reflexão final
O processamento e a limpeza dos dados são fundamentais porque os métodos estatísticos dependem diretamente da qualidade das informações utilizadas. Erros de digitação, valores ausentes, informações em formatos diferentes ou valores fisicamente impossíveis podem alterar os resultados dos cálculos e levar a conclusões incorretas. Na Engenharia Civil, é especialmente importante verificar também se os valores são coerentes com as características físicas dos materiais e dos processos analisados.
O principal problema encontrado na base de dados foi a presença de inconsistências e erros no preenchimento das informações, principalmente nas variáveis que deveriam representar valores numéricos. Alguns dados estavam registrados como texto, havia diferentes formas de representar os números, erros de digitação e também valores ausentes. Além disso, foram identificados alguns valores que não eram coerentes com as características físicas esperadas para as propriedades do concreto analisadas.
Para tratar esse problema, foi realizada uma etapa de limpeza, correção e padronização dos dados antes da aplicação dos cálculos estatísticos. Os valores que apresentavam erros de digitação foram analisados individualmente e corrigidos quando era possível identificar claramente a informação pretendida. Também foram padronizados os formatos dos dados para que pudessem ser utilizados corretamente nas análises realizadas no R.
Um ponto importante foi que não foram feitas correções automáticas sem considerar o significado dos dados. Quando um valor não apresentava informação suficiente para determinar qual seria o valor correto, decidiu-se mantê-lo como dado ausente, evitando criar uma informação que não estava presente originalmente na base. Dessa forma, a decisão adotada buscou preservar a maior quantidade possível de informações confiáveis e, ao mesmo tempo, evitar que erros presentes na base influenciassem negativamente os cálculos estatísticos e as conclusões da atividade.
## Aprenda Quarto
Acesse [Quarto](https://quarto.org/).
## 📖 Referências